 Lingee Bench
白皮书
摘要:Lingee Bench(代号 lg-bench)是面向企业业务任务与流程的 Agent 评测基准,回答一个核心问题:在明确的业务上下文与资源约束下,Agent 能否在业务系统中完成可核验的业务成果。评测数据集是本基准的核心贡献:通用领域 500 题承载基础能力,企业管理领域 900 题(财务、供应链、制造各 300 题)承载业务流程能力,合计 1400 题,组织协同层列为后续扩展方向。配套的统一评测框架保证可复现:任务以统一目录打包、在完全内置依赖的 Docker 环境中离线执行,经确定性规则校验与 LLM Judge 双通道评分聚合为任务得分(Task Score),同时报告 token 等效率指标与 reliability@k 稳定性指标。评测集由分布相同的公开组(首批开源 65 题)与保留组构成,通过监控两组表现差异持续测量数据污染,并以版本轮换保持评测集常新。
首期评测在公开组上完成灵基、DeepSeek Harness、OpenCode 三个 Harness 的受控横向对比,评测配置按七层披露清单以统一结果卡全量公开;任何分数均归属于“Agent × Harness × 环境 × 评测器”的组合,不构成对其他模型或 Harness 的评价,也不直接换算为业务价值。本白皮书以六道代表性题目(通用 3 道、企业 3 道)的深度分析呈现评测体系的运作与结果的解读,关键发现有二:企业业务场景的第一分水岭是领域取数方式而非计算能力;内容正确与交付合规是两类独立能力,双通道评分将其分开度量。
关键词:Agent 评测;企业业务任务与流程;Benchmark;任务得分;token 效率;防污染
1业务问题与基准定位
1.1 企业 Agent 落地趋势与评测缺口
这一轮智能技术变革正处在关键节点,行业的判断正在形成两点共识。模型侧,智能上界仍在持续跃迁,人工智能正从解决“语言”问题走向解决“行动”问题:能够理解并执行长程、多步、跨系统任务的自主智能体,被视为通向工业级可靠生产力的下一个台阶,前沿模型厂商正将研发重心投向长程任务与自治智能体系统。企业侧,管理软件行业正整体转向 AI 原生,AI 从附加的功能模块升级为承载业务运行的系统层,企业管理被视为智能体落地的主战场。当“让智能体承担企业核心业务”从愿景变为产品承诺,“如何客观度量智能体的真实业务能力”就成为整个链条上无法绕过的一环。
在企业软件场景中,财务核算、供应链计划、制造运营等核心管理域流程长、规则密、数据关联复杂,既是 Agent 价值密度最高的落地域,也是对评测体系要求最高的场景:一个Agent能否“干企业里的活”,取决于它能否在真实业务系统中理解模糊的需求、定位正确的数据、执行合规的操作并产出业务上正确的结论。金蝶作为企业云管理软件厂商,业务覆盖财务、供应链、制造等核心管理域,具备提供真实企业评测场景与业务级判定标准的天然条件。
与落地进度相比,评测体系明显滞后。现有评测多面向通用能力或代码工程任务,难以回答两个基本问题:其一,Agent 在企业真实工作场景中的任务完成能力如何度量——回答这个问题,前提是一套取自企业真实工作场景的任务数据集,而这正是当前最稀缺的资源;其二,评测结果是否可校验、可复现、可比较——评测方法的最新共识是,Agent 成绩是模型、Harness(执行脚手架)、环境与评测器四类因素的联合产物[1][2],公开评测必须配置透明、他人可复现,其分数才具备可归因性。
1.2 现有 Agent 基准的局限
我们对 37 个行业评测榜单进行了系统调研(完整清单见附录 D),覆盖通用 Agent、Web/GUI、代码工程、企业办公与聚合型五类。调研对象的选取遵循两条标准:
- 公开可查——有论文、官方文档或公开榜单页可供核验;
- 与 Agent 评测直接相关——评测对象为 Agent 或其核心能力组件。
在此之下按五类覆盖,逐项核验其评测场景、数据开源、评分方式与更新状态,完整清单见附录 D。专业成果验收方向的公开实践亦可作参照:GDPval 以领域专家盲评度量 44 个职业的真实工作成果[3],但其任务取自美国职业场景、以单次评估为主,未覆盖 ERP 业务链路,也说明了此类范式与企业业务流程评测的互补关系。调研显示现有基准存在三类系统性缺口。
其一,企业业务深度空白。企业办公类仅 5 项,且各有硬伤:OfficeBench 基于模拟办公软件而非真实业务系统;Salesforce CRM Benchmark 的代码、数据与评分器完全封闭,用户无法自行复现;WorkArena 基于真实 ServiceNow 平台但需审批访问远程实例;DrBench 面向深度研究场景;AgentLab 是评测框架而非独立基准。尚无一项覆盖财务凭证、供应链计划、制造运营等 ERP 核心业务链路,中文企业场景更是完全空白。
其二,业务级校验稀缺。调研的 37 项榜单中 32 项发布开源数据集(含 2 项部分开源),但判定方式以通用匹配(精确匹配、单元测试、状态断言)为主,采用 LLM-as-judge 的仅 5 项(另有 2 项部分采用)。企业任务的“正确”往往由业务规则定义,例如:凭证是否借贷平衡、库存扣减是否与单据一致,而非字符串是否匹配。调研中没有任何一项基准具备“业务专家人工确认预期输出”的机制。
其三,静态基准快速饱和。SWE-bench Verified 的联合构建方 OpenAI 于 2026 年 2 月发布题目审计并宣布不再以该基准评测模型[4]:其审计的 138 道题中,o3 在 64 次独立运行中未能稳定解决的约占 60%,存在测试定义过窄、题面缺陷等实质问题而实际不可解;公开仓库被大规模抓取也使题目面临训练数据污染风险,头部模型得分已饱和至 80% 上下。这说明一次性静态快照的评测集寿命有限,评测集必须具备持续更新机制。
此外,Harness 评测研究指出,在长程任务上 Harness 引起的分数方差可达模型方差的 7.8 倍,未披露 Harness 配置的榜单会把脚手架收益误记为模型进步[5]。评测配置的披露与可复现性,正在成为评测可信度的先决条件。
1.3 Lingee Bench 的定位与贡献
Lingee Bench(代号 lg-bench)是金蝶结合真实企业业务打造的企业级、版本化的 Agent 评测套件:面向企业业务任务与流程,提供统一的任务体系、评测框架与受控执行环境,测量 Agent 在离线可控的企业业务环境(ERP 沙箱)中完成端到端任务的能力。首期评测在公开组 65 题上完成了灵基、DeepSeek Harness、OpenCode 三个 Harness 的受控横向对比,任何分数都归属于“Agent × Harness × 环境 × 评测器”的组合,锁定 Harness 提高的是同一组合内比较的一致性,不应将分数归因于单一因素(见 5.3 节)。
配合本次白皮书,我们同步发布以下内容。一是评测问题集第一版:通用领域 500 题与企业管理领域 900 题(财务、供应链、制造各 300 题)合计 1400 题;为避免题目泄露导致的污染与过拟合,其中首批开源 65 题,随附任务目录与 Docker 环境定义、可离线复现,其余题目不直接开源,通过Lingee Bench 官方网站提交评测。二是统一、可复现的评测框架与方法论,这是本文的主体(第 4 章),配套的评测协议、隐藏集治理规则、评分规范与统计报告规范四份文档随发布版一并公布(见附录 C)。三是题目级深度分析(第 5 章):从公开组抽取六道代表性题目逐题剖析;全量 1400 题的运行结果,65 题对比统计在审核中(见附录 C)。
与行业基准相比,Lingee Bench 的差异化体现在三个层面。场景层面,在中国厂商已发布的 Agent 基准(腾讯 WorkBuddy Bench[6]、字节 Multi-SWE-bench、Web-Bench、EdgeBench,阿里 DeepPlanning,华为 OmniBench,MiniMax OctoCodingBench,智谱 VisualAgentBench 等)中,Lingee Bench 是唯一以 ERP 核心业务为场景的基准;校验层面,“确定性规则+LLM Judge 双通道+业务专家确认预期输出”的组合在 37 个被调研评测集中无先例;框架层面,开源题目执行环境完全内置、离线可复现、评测配置全量披露,保留题目经官方网站受控评测,避免了封闭评测与审批门槛两类常见障碍。
上述设计背后的核心价值与创新点可以概括为四条。其一,企业业务深度:聚焦 ERP 核心业务(财务、供应链、制造),题目源于这些领域的真实业务任务,而非以业务为包装的通用任务,并以业务专家确认的预期输出定义“业务级正确”,回答现有基准无法回答 Agent 能否承担企业里的真实工作。其二,分布相同的公开/保留双组:把防污染从构造时的静态假设变为可持续测量的信号(见 4.4 节),并以公开组承载可复现性、保留组承载可信度,结构性化解“全公开易污染、全保密不可复现”的两难。其三,locked-harness 全披露:锁定统一执行脚手架并按七层清单全量披露配置与推理参数,使每个分数的归属组合(Agent × Harness × 环境 × 评测器)透明可查、同一组合内的比较具备一致性,将评测方法研究的最新实践系统落实到企业场景基准的设计中。其四,业务级校验体系:确定性规则与 LLM Judge 双通道配合预期结果五类型、精度偏差与工具链路判定,使开放性业务任务也能被可靠评分。
1.4 本基准的使用方式与适用边界
本基准面向三类使用场景。其一,产品研发选型:以同一评测资产上的受控对比与失败模式分析,判断优先改进模型能力、上下文组织、工具连接、控制设计还是交互方式。其二,客户采购验证:客户与伙伴可基于公开组题目与配套评测环境,在熟悉的业务任务与统一验收规则下开展概念验证,缩短反复演示与争论的验证过程;任务与验收规则也可迁移到客户自有数据上按第 6 章的方案执行。其三,行业研究与协作:研究者可在离线环境复现评测结果、检视评测方法与结论,并以贡献任务、适配工具等方式参与共建(见第 7 章)。
使用本基准结果时须遵循三条边界。结果绑定被评组合与评测资产版本,不同题目版本、评测配置下的分数不可直接比较;公开组 65 题承载首轮评测运行与六题深度分析,案例结论不外推为全量分布的定量推断;本基准测量离线沙箱中的任务与流程能力,不直接回答在线生产环境中的表现,也不直接换算为业务价值(见 3.2 节、5.3 节、第 6 章)。
2业务覆盖与任务体系
2.1 设计原则
Lingee Bench 的设计遵循五条原则。(1)真实场景驱动:题目源于真实业务与办公场景及其合理抽象,场景分布贴近真实工作频率;(2)结果可校验:每题配套预期输出与校验规则,以确定性规则校验与 LLM Judge 双通道评分;(3)可复现:评测所需的数据、工具与依赖全部内置 Docker 镜像,剥离外部 MCP 与 API 调用,第三方可离线复现;(4)防污染:题目基于场景与公开资料重构合成,题面不可被搜索命中,并配合版本化管理;(5)持续演进:题目持续补充与更新,发布快照按版本迭代。五条原则分别在后续章节展开:真实场景见第 2、5 章,可校验见 4.3 节,可复现见 3.2 节,防污染见 4.4 节,持续演进见 2.3 与 7.2 节。
2.2 三层评测架构与领域体系
Lingee Bench 以“从任务完成到业务闭环”为主线组织评测:不仅度量 Agent 能否完成孤立的操作,更度量它能否在业务系统中推动一条业务任务链达到可核验的正确终态。为此,基准按三个层级组织评测能力,由通用领域与企业管理领域两部分构成(图 1)。
第一层为基础能力,由通用领域承载:以可核验的专业工作包为评测单位——多表核对、供应商比较、知识库检索、文档校验与日程处理等——衡量 Agent 支撑业务的基础能力是否合格。第二层为业务流程,由企业管理领域承载,是首版的核心:以系统中端到端的业务任务链为评测单位——从凭证录入到过账结账、从订单到出入库——同时核对业务产物、业务状态与必要控制,度量业务任务能否闭环。第三层为组织协同,面向跨岗位、跨时间的业务事件持续处置,检验目标约束、责任交接、持续跟踪与人机协作,列为后续版本的扩展方向(见第 8 章);多 Agent 数量本身不作为评价维度。
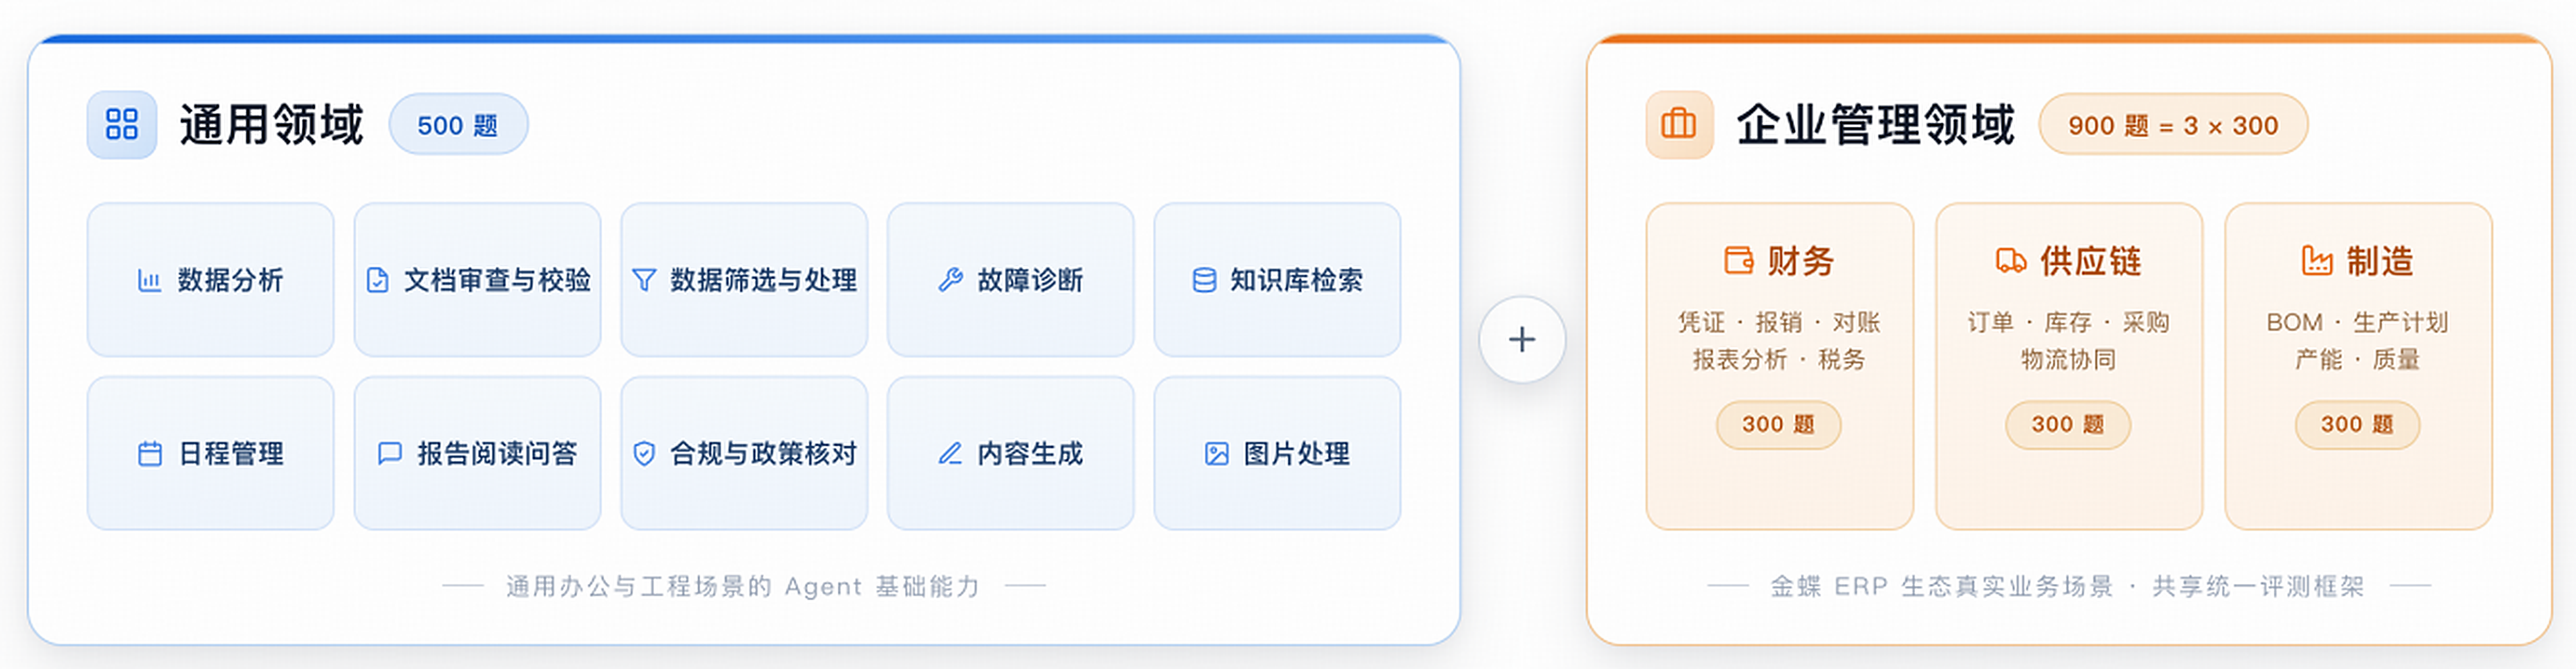
图 1 Lingee Bench 两大领域构成(合计 1400 题)
不同领域共享同一任务目录规范与评测框架,评分器按领域可插拔:通用能力看广度,即跨任务类型的适应性;企业场景看深度,即业务规则遵从与跨模块流程闭环。统一框架保证跨领域的分数口径一致,领域差异只体现在题目与校验资产上,不体现在评测管线上(见 4.3 与 5.3 节)。
2.3 题目规模、任务家族与分布保障
本基准共 1400 题:通用领域 500 题,企业管理领域 900 题,财务、供应链、制造三个维度平均分配、各 300 题。开放策略上,首批开源 65 题构成公开组,其余 1335 题构成保留组、经Lingee Bench 官方网站提交评测,两组分布相同(见 4.4 节)。公开组 65 题在全量 1400 题之内,按 4.4 节的三步构造法以场景类别、操作类型与难度分层为准分层抽取,随评测问题集封板一并冻结;首轮评测运行与六题深度分析均在同一公开组上产生、在相同集合上比较,不与全量口径混合报告(见第 5 章)。通用领域(公开组)的十大类构成见表 1。
表 1 通用领域十大类构成(公开组)
| 分类 | 题量 | 占比 | 题目示例 |
|---|---|---|---|
| 数据分析 | 5 | 8% | 成本超支归因下钻、区域经营环比分析 |
| 文档审查与校验 | 5 | 8% | 合规红线词扫描、合同条款风险多轮审查 |
| 数据筛选与处理 | 4 | 6% | 财经情报智能筛选、费控数据SQL查询 |
| 故障诊断 | 4 | 6% | 报错根因多跳定位、事件升级处置 |
| 知识库检索 | 4 | 6% | 收票自动填报检索、退款冲回连环追查 |
| 日程管理 | 3 | 5% | 会议日期政策检查、跨时区会议换算 |
| 报告阅读问答 | 3 | 5% | 年报资本开支占比问答、ESG报告阅读问答 |
| 合规与政策核对 | 3 | 5% | 报销合规逐条核对、需求可行性逐条响应 |
| 内容生成 | 2 | 3% | 多文件合并去重、模板批量填充 |
| 图片处理 | 2 | 3% | 发票合同图像核对、多发票批量识别入账 |
企业管理领域的题目需要 Harness 操作镜像内置的模拟 ERP 专业系统 MCP 工具接口完成任务,更侧重于对领域场景内专业知识、工具和逻辑理解能力的考核。题目(公开组)详细构成见表 2。全部样本三个维度各 300 题、平均分配;各维度内部的场景分布与构成遵循 2.5.2 节的四维分配框架。
表 2 企业管理领域构成(公开组)
| 维度 | 题量 | 占比 | 场景重点 | 选择理由 |
|---|---|---|---|---|
| 财务 | 14 | 22% | 凭证、报销、对账、报表分析、税务 | 数据严谨性与合规约束最强 |
| 供应链 | 9 | 14% | 订单、库存、采购、物流协同 | 计划与协同复杂度高 |
| 制造 | 7 | 11% | BOM、生产计划、产能、质量 | 工业场景链路最长 |
题量本身不是业务代表性的充分证据,代表性由任务家族覆盖保证。每道题目归属一个任务家族——同一业务目标下不可互相替代的独立业务场景;同一家族内的模板变体只计一个独立场景,不作为独立任务累计。题目分布按场景类别、操作类型与难度分层的配比控制(见 2.5.2 节),并以入库质检的去重检查(语义重复率超过 80% 即去重,见 3.3 节)防止近似题目虚增规模。1400 题的构成明细(任务家族清单、各维度场景与难度分布)随发布版公布。
2.4 通用领域
2.4.1 定位与能力分类
通用领域衡量 Agent 在通用办公与工程场景中的基础能力,覆盖十大类:数据分析、文档审查与校验、数据筛选与处理、故障诊断、知识库检索、日程管理、报告阅读问答、合规与政策核对、内容生成、图片处理。各类构成见表 1(2.3 节)。
2.4.2 各类能力说明
通用领域的题目按所考察的能力归类,而非按题目形式或数据来源归类:数据分析考察对业务数据的归因下钻、对比分析与预测;数据筛选与处理考察对结构化数据的清洗、筛选与查询,包括 SQL 查询;文档审查与校验考察对合同条款、表单与票据的规则校验与交叉核验;合规与政策核对考察对政策制度的逐条核对与版本冲突识别;报告阅读问答考察对长篇报告的阅读理解与数值计算;知识库检索考察在企业知识库中的多跳检索与逻辑追查;日程管理考察带约束的日程安排与跨时区换算;图片处理考察对票据与单据图像的识别与核对;内容生成考察模板化文档的合并与批量产出;故障诊断考察对报错信息的根因定位与升级处置。
2.4.3 题目示例
题目以统一卡片格式展示,包含五个要素:任务描述(口语化原文)、输入资产、校验点清单、得分构成、欠规范化设计说明。
以下给出三道代表性题目卡片,分别取自图片处理、数据分析与知识库检索三个大类,覆盖单轮与多轮两种任务形态;三题的跨 Harness 逐题对比分析见 5.2 节。
示例一 多发票批量识别入账(图片处理·L2·单轮;任务 ID:IMG-multi-invoice-batch-recognition-L2)
任务描述:多张发票批量入账:input/ 下有三张独立的发票图片,需逐张识别并汇总。逐张识别每张发票的发票号码与价税合计,计算三张的汇总总额写入 output.xlsx,不得遗漏任何一张。
输入资产:三张独立发票图片(invoice_1.png~invoice_3.png)与任务说明 task.json,全部为合成数据;环境离线运行,不联网、不调用外部接口。
校验点清单:三张发票号码的识别与规范格式(INV-X-####,须保留连字符);三张价税合计金额;汇总总额等于三张之和;明细行与合计行的表格结构;每张号码与金额对来源图片的对应引用;result.json 必填字段(produced_file、summary、format_check);无编造内容、无禁用词与联网链接。
得分构成:规则校验与 LLM Judge 双通道加权合成,各占 50%。金额正确性为致命项——任一张发票金额错误即整题判零;Judge 按五项分级档位 rubric 评定:金额与汇总、号码格式、表格结构、来源引用、无编造。
欠规范化设计说明:产物层仅强制最小契约——明细表至少含发票号码与价税合计两列,辅助列与呈现形式自由;金额按数值等价口径核对,数值单元格与千分位字符串视为同一金额;识别手段不限,题面明示“评测只看产物是否符合契约与业务正确性,技能内部的工具调用链属实现细节,不作为评分对象”。
示例二 成本超支归因下钻(数据分析·L3·多轮;任务 ID:DA-cost-overrun-attribution-drilldown-L3)
任务描述:成本超支归因下钻:分三轮——算各部门超支率→下钻定位超支科目→整改测算定稿。第 1 轮按(实际−预算)/预算计算各部门超支率并指出最大超支部门;第 2 轮对该部门下钻科目明细,定位超支科目及金额;第 3 轮针对主因科目给出整改测算与建议。后一轮须基于前一轮结论继续,不得照搬上一轮,每轮产物按轮落盘。
输入资产:部门预算与实际数据 dept.xlsx、科目级明细 subject_detail.xlsx、任务说明 task.json、逐轮指令 turns/turn_1~3.md。
校验点清单:六个规则组——三轮产物按目录契约落盘(turn_1/dept.md、turn_2/drill.md、turn_3/plan.md);第 1 轮超支率计算与最大超支部门判定;第 2 轮超支科目定位及金额;第 3 轮整改方案须含测算数字;result.json 的 metrics 与 key_findings 字段;安全禁用词组。Judge 三项分级档位 rubric 分别核对三轮结论的正确性。
得分构成:规则校验与 LLM Judge 双通道加权合成,权重分别为 70% 与 30%。
欠规范化设计说明:第 2、3 轮的分析对象不出现在题面中,由第 1、2 轮的结论动态决定,须真正完成跨轮衔接而非按预设对象作答;第 3 轮整改建议为开放式命题,多种合理方案均可得分,判定要点为是否针对主因科目并给出测算数字;每轮产物为 Markdown,行文结构不作限定。
示例三 退款冲回连环追查(知识库检索·L4·单轮;任务 ID:KBR-refund-reversal-chain-tracing-L4)
任务描述:两张退款工单的连环追查:供应商部分退货需退回 2,000 元、住宿费重复入账需退回 1,500 元,沿七个环环相扣的问题逐步追查(退款机制与版本补丁、冲回单据的两步处理、决定冲回上限的隐藏金额字段及其公式验算、报销勾选的自动配置、员工自助端的反向操作、依据文章的时间线排序、通用退款方式归纳与第二张工单的收口判定),关键结论后以【文章标题】标注来源。
输入资产:金蝶云社区“人人报销/费用管理”知识专题镜像——69 篇 Markdown 文章(文件名为文章 ID,文首为文章标题);两张工单的业务情境在题面中给出。
校验点清单:23 个规则组分项核对七问的逐项结论——版本号、补丁号、上线日期、公式、参数值与天数差等以知识库原文为准,计算问须给出数值结果;Judge 六项分级档位 rubric 核对语义质量,包括两步处理顺序、隐藏字段取值规则、退款方式与金额限制的归属、第二张工单的收口结论、引用接地(来源标题须真实存在且指向正确,不得出现清单之外的捏造标题)与无编造(不得虚构知识库中不存在的功能或参数)。
得分构成:规则校验与 LLM Judge 双通道加权合成,各占 50%;Judge 依据的证据摘录自知识库原文、评测前冻结,Judge 不访问工作区;判分配置经标准答案、基线答案与对抗答案三类样本的准入校验。
欠规范化设计说明:题面不给出任何文章标题、字段名或参数名——七个问题环环相扣,后一问的检索线索(概念名、单据名、参数名)往往出现在前几问读到的文章里,须以已检索内容中的术语发起下一轮检索;相近主题的文章并存,须甄别依据出处、不得张冠李戴;知识库中查不到的内容允许如实标注“知识库未提及”,不视为失败。
2.5 企业管理领域
2.5.1 定位与设计思路
企业管理领域衡量 Agent 在真实企业业务系统(金蝶 ERP 生态)中完成端到端业务任务的能力。与通用领域相比,它有三个特征:业务数据密集(多表、多单据、跨期数据关联);流程跨模块(录入→审核→过账→结账的完整链路);结果有业务级对错(由会计准则与业务规则定义,而非表层文本匹配)。选择财务、供应链、制造三个维度的理由:财务的数据严谨性与合规约束最强,供应链的计划与协同复杂度高,制造的工业场景链路最长——三者共同覆盖企业管理核心域的典型难度谱系。
业务领域与行业是两个正交的维度:财务、供应链是跨行业的业务职能,制造则是行业场景。本基准的三个维度覆盖“职能 × 行业”的组合——财务与供应链维度以职能为主线覆盖各行业的共性业务,制造维度以制造行业为场景纵深其生产运营业务。行业不另设互相重复的题库,而是作为任务标签维度纳入任务元数据(见 2.6 节),支持按行业、企业规模、岗位、流程阶段与风险等级对任务切分统计;跨维度共享的业务能力以标签展示,不重复计数。
企业管理领域问题集由长期深耕企业管理各业务领域的资深业务专家主导设计。每位专家在各自擅长的领域内,围绕真实业务场景中的高难度研究任务独立命题、独立构造,兼顾高频诉求与关键长尾场景,确保任务本身具备足够的业务深度与专业门槛。
在任务设计过程中,专家以金蝶在 ERP 领域多年的经验沉淀作为方法论基础:一方面深入一线用户场景,系统梳理用户的真实诉求、操作习惯与业务痛点;另一方面对标行业标杆实践,萃取领先企业的管理经验与最佳做法。两者相互印证、彼此补强,最终转化为结构清晰、语义明确、难度可分层的问题集。
由此形成的企业管理领域问题集并非简单的题目汇编,而是经过专家人工设计与加工的业务数据资产:每一条任务都对应明确的业务语义、贴近真实业务的数据形态与可验证的评测目标。它既来源于实践,又反哺实践,能够持续支撑企业级智能能力的评测与优化。
2.5.2 场景体系的四维分配框架
领域内按业务功能模块组织场景分配,并以四个维度保证覆盖的系统性。
第一维,业务功能:每个功能项(如凭证录入、凭证审核、凭证过账)至少配置 1 题;高频功能加权配置 3~4 题;至少覆盖 1~2 条端到端业务链路(如凭证录入→审核→过账→结账),而非各功能孤立;功能边界场景(用户请求 Agent 执行其不支持的功能时,应正确拒绝或引导)纳入覆盖。
第二维,操作类型:查询、操作、分析、文档处理四类按表 3 的配比组织,单一操作类型不超过 50%。
表 3 操作类型说明
| 操作类型 | 说明 |
|---|---|
| 查询类 | 信息检索、余额查询、明细查询等 |
| 操作类 | 录入、审核、过账、出库等(创建/审批/修改/删除各有最低条数) |
| 分析类 | 趋势分析、对比分析、异常识别等 |
| 文档处理类 | 打印、导出、生成报告等 |
第三维,难度分层:按执行复杂度与认知复杂度双轴定义三个层级,配比见表 4。
表 4 难度分层定义
| 难度 | 执行复杂度 | 认知复杂度 |
|---|---|---|
| 简单 | 单步操作、不跨功能,交互不超过 3 轮 | 意图明确、信息完整,一次输入即可完成 |
| 中等 | 多步操作或跨 2 个功能,大数据量需分页或汇总,交互 3~8 轮 | 隐含条件需简单推理,或涉及跨期数据对比 |
| 困难 | 多步跨功能、完整业务链路,交互 8 轮以上 | 模糊表述或多意图,需深度业务推理、风险确认或纠偏 |
第四维,异常处理:覆盖企业场景中最常见、评测价值最高的四类异常(表 5),每个业务模块对每类异常至少配置 1 题,以考察 Agent 的鲁棒性。
表 5 异常场景类型
| 异常类型 | 说明 | 设计要求 |
|---|---|---|
| 业务规则违反 | 凭证借贷不平衡、报销金额超标准、期间已锁定不允许录入等 | 每业务模块至少 1 题 |
| 空结果 | 查询条件无匹配数据,应正确提示而非报错 | 每业务模块至少 1 题 |
| 异常状态 | 已作废单据不能修改、已审核凭证不能直接删除等 | 每业务模块至少 1 题 |
| 输入错误 | 无效客户编号、错误日期格式等,应校验并提示 | 每业务模块至少 1 题 |
2.5.3 业务级校验体系
企业管理领域的校验以双资产为基础:预期输出(业务正确结果)与校验规则文件;全部预期输出经金蝶业务专家团队人工确认准确性。预期结果归属五种类型之一(表 6),精度与偏差范围见表 7。
表 6 预期结果类型
| 结果类型 | 说明 | 示例 |
|---|---|---|
| 确定值 | 有单一确定的数值或状态结果 | 2026 年 9 月管理费用余额为 125,000 元 |
| 状态变更 | Agent 执行后系统状态发生确定变化 | 凭证从“未审核”变更为“已审核” |
| 集合 | 返回一个或多个符合条件的结果项 | 逾期超过 90 天的客户共 3 家:A 公司、B 公司、C 公司 |
| 操作成功确认 | 操作类任务的确定性成功反馈 | 报销单已成功提交 |
| 合理范围 | 无唯一答案,落在合理范围内即判定正确 | 推荐付款方式:给出“银行转账”或“网银支付”均算对 |
表 7 精度与偏差范围
| 数据类型 | 精度要求 | 偏差范围 |
|---|---|---|
| 金额 | 保留两位小数 | ±0.01 元 |
| 数量 | 保留两位小数 | ±0.01 |
| 百分比 | 保留两位小数 | ±0.01% |
| 日期 | 精确到日 | 无偏差 |
| 文本 | 完全匹配或语义等价 | 语义相同即可,忽略大小写与标点差异 |
多答案场景的处理规则:存在多个合理答案时,给出任意一个合理答案即判定正确;要求列出全部符合项时必须无遗漏,缺少任一判为部分正确;排序类结果顺序正确为完全正确,内容正确但顺序错误为部分正确;开放式分析不要求严格匹配,由 Judge 按分级档位评定(优秀、合格、不合格)。
以困难场景“这个月的账不对劲,帮我看看”为例:预期工具链路为查询当期凭证列表→检查异常凭证(借贷不平衡、未过账)→定位具体问题→输出排查结果;关键判定点是 Agent 在发现异常后是否主动呈现问题清单并询问是否修复;跳过凭证状态检查直接修改等行为按部分正确处理。
2.5.4 题目示例
企业领域题目卡片沿用 2.4.3 节的统一卡片格式与五要素结构。以下三题分属财务、供应链、制造三个业务模块,均在模拟的金蝶 ERP 业务系统中通过专业系统工具接口完成任务,以内容判据(LLM Judge)与独立数值规则核验双通道评分;三题的跨 Harness 逐题对比分析见 5.2 节。
示例一 十二月经营分析报告(财务·单轮;任务 ID:finance-fa-20)
任务描述:帮我生成一份星空旗舰应用测试2024年12月的经营分析报告。数据范围为该组织 2024 年 12 月的资产负债表、利润表与现金流量表,辅以 2024 年 6 月的科目余额资料;交付 Markdown 分析报告与 HTML 互动报告,正文覆盖资产负债、收入、现金流、偿债能力等 13 个分析主题。
输入资产:组织“星空旗舰应用测试”的模拟 ERP 业务数据——三大报表、科目余额、元数据与维度数据,通过 ERP 专业系统 MCP 工具接口按需取数;默认核算体系,币种为人民币、金额基础单位为元;本题为只读分析。
校验点清单:16 项内容判据——13 个分析主题逐项核对,资产质量、偿债能力等主题设有实质要求(仅列构成不满足);HTML 互动报告须含可显示的 ECharts 图表、卡片布局与抽屉导航;各主题须有数据来源标注与时间戳;用户可见内容须脱敏。数值核验 4 组——营业收入、资产总计、负债合计、资产负债率、货币资金、经营活动净现金流,按指定“财务指标数值表”的表名与列名读取,正文数字不作为补取来源。
得分构成:内容判据(LLM Judge)与数值规则核验双通道加权合成,权重分别为 70% 与 30%;数值验收执行结果表契约——一指标一行、数值格仅填数字、缺失写“无法计算”,同一业务键在多个产物中的结果须一致。
欠规范化设计说明:金额单位可在元、万元等之间自选、注明即可,按同一币种正确换算即视为对齐;允许同义标题或合并章节,只要能定位到各主题的内容;某主题缺少适用数据时说明缺口及影响,不把未获取数据当零、不编造比率或业务原因;六月辅助资料与十二月报表须分表列示并标明实际期间,不得混用口径。
示例二 一月销售月报(供应链·单轮;任务 ID:supply-chain-tc-059)
任务描述:生成2026年1月销售月报,分析客户和物料贡献、交付异常、回款风险,并给下月行动建议。签单指标以 2026 年 1 月审核通过的销售订单为范围、按审核日期归入本月;交付逾期判断使用月报截至日 1 月 31 日,不使用实际执行日。
输入资产:组织“星空旗舰应用测试”个人视图的销售业务数据——销售订单、交付与退货记录、经营指标数据等,通过 ERP 专业系统 MCP 工具接口按需取数;跨币别数据按系统报表口径展示,金额的币种与单位应可识别。
校验点清单:3 项内容判据——订单概况与客户、物料贡献分析;交付异常与回款风险分析(风险判断须说明所依据的业务数据,已取得事实与未取得的信息边界清楚);下月行动建议(须针对本次月报发现的问题,与已发生事实分开标注)。数值核验 3 组——签单金额、订单笔数、准时交货率与退货率,按指定“本月销售指标”结果表读取,正文数字不作为补取来源。
得分构成:内容判据(LLM Judge)与数值规则核验双通道加权合成,权重分别为 60% 与 40%。
欠规范化设计说明:报告载体自选——可在最终回复中交付完整月报,也可交付 HTML、Markdown 或 Excel 报告文件;未取得的字段写“未提供”、不能填零,比率计算口径须有业务依据、不得按既有数字反推分母;订单数据未提供业务员时按组织范围统计并说明该限制,不得把创建人、审核人或登录人猜作业务员。
示例三 两日工序质量对比(制造·单轮;任务 ID:manufacturing-qc-029)
任务描述:帮我对比一下2026年10月3日和10月4日的工序质量情况,首检通过率、巡检异常率和缺陷Top5分别有什么变化。统计两日全部已审核工序检验记录,在最终回复中交付总体指标表、缺陷 Top5 对照表与工序定位表三张表及分析,无需落盘文件。
输入资产:两日的工序检验记录,首检(自制工序检验)与巡检两类分别计算,通过 ERP 专业系统 MCP 工具接口按需取数;统计口径公开——首检以“检验单号+生产计划明细”为批次、批内抽样结果全部为 B 才算通过,巡检按记录行计算、不合格数量大于零记为异常,缺陷按处理方式计明细次数、不按数量加权。
校验点清单:4 项内容判据——总体指标表的覆盖与口径;缺陷 Top5 对照表(覆盖两日前五类型的并集,识别新增、消失与名次变化,未入前五写“未入前五”、同频并列);质量变化解读(结合总体巡检记录数判断异常数与异常率是否同向,区分分母变化与数量变化);工序定位表(按公开的异常率增幅排名规则选择工序,关注理由与证据对应)。数值核验 6 组——首检通过率、巡检异常率、缺陷总数(可选)、巡检记录数、异常巡检记录数的两日对比,以及异常率增幅前两工序的完整定位数据。
得分构成:内容判据(LLM Judge)与数值规则核验双通道加权合成,权重分别为 60% 与 40%;比率按一位小数百分点精确比较、计数按整数精确比较,不设舍入容差。
欠规范化设计说明:三张表列序不限、每项仅给一组主结果;缺陷总数为可选项、如实报告;数据缺失或分母为零写“无法计算”并说明原因,未知值不用零代替;数值变化按 10 月 4 日减 10 月 3 日、以两日展示值相减,排名使用变化百分点差值。
2.6 任务构造与任务目录规范
每道题目以自包含的任务目录打包,采用 Harbor 风格的目录约定,一个任务目录由三部分构成:任务定义——instruction.md 承载自然语言任务描述,task.toml 以结构化字段声明任务元数据与环境配置;执行环境——environment/ 定义 Docker 环境,题目所需的数据资产打包为 workspace.tar.gz 随环境携带,解包后即为 Agent 可见的工作区;判分资产——tests/ 存放评测资产,verifier.toml 与 test.sh 定义判分入口,gold/ 收录预期输出、冻结证据与三类准入样本,grading/ 收录确定性校验规则与判分脚本,judge.yaml 定义 Judge 评分规则。评测资产与 Agent 在执行期严格隔离:Episode 进行中,Agent 只能见到任务描述与工作区;校验资产在 Agent 运行结束后才被评测管线引入。这一隔离由目录约定与评测管线在架构上强制实现,与发布策略相互独立:校验规则对外公开,预期输出保密(见附录 C)。
每个任务目录携带结构化元数据,至少包括:任务家族与场景类别,行业与企业规模标签,岗位与流程阶段,操作类型与难度分层,业务风险等级,来源与授权说明,预算(超时、步数、token),允许的多种解法说明,终态验证器与交互脚本指针,以及已知限制。元数据支撑按维度切分统计与分布配比核查(见 2.3 节),也是任务家族清单与行业标签统计的数据来源。
任务构造流程分为五步:场景与数据源选取、口语化任务描述改写、欠规范化设计、校验资产编制、质检入库。整个流程贯穿两条主线。其一,可评测性前置:一道题在写成之前,先要确定它将如何被判定对错,凡无法定义可判定预期结果的场景不纳入出题范围。其二,真实用户视角:题目从表述到数据都取自真实用户的工作方式,不为评测方便而改成考试式的简化表述。
第一步,场景与数据源选取。依据领域场景体系确定出题范围:通用领域按十大类配比选取场景(见 2.4.1、2.4.2 节);企业管理领域由业务专家在真实业务场景中独立命题,并按四维分配框架在业务功能、操作类型、难度分层与异常处理上做覆盖配比(见 2.5.1、2.5.2 节)。数据源遵循统一口径,全部评测数据由公开资料合成、不使用任何真实企业数据(见 3.1 节)。这一步的注意点有二:一是场景与配比对齐,高频功能加权、关键长尾不漏,每条端到端业务链路至少有题覆盖;二是数据基础先行,按完备性、有效性、可验证性三性核查题目所依赖的数据(见 3.3 节),数据不满足三性的场景暂缓出题。
第二步,口语化任务描述改写。把场景改写为用户口吻的任务描述,遵循三条规范:使用自然的中文用户表达,不用系统指令式或代码式表述;信息密度适中,贴近真实用户习惯,不刻意省略必要信息也不过度赘述;还原真实业务上下文,而非孤立的技术操作。改写中须区分模糊意图与意图不清晰两类表述:前者是合法考点,如“这个月的账不对劲,帮我看看”模拟了用户的模糊表达,但其评测意图清晰——考察 Agent 能否识别“不对劲”的业务含义(借贷不平衡、期间未结、异常波动等)、主动澄清并逐步排查,此类题目归入困难层级;后者则是不合格表述,如“处理一下”,连评测者都无法确定考查目标,在质检的语义清晰度检查中不予通过。
第三步,欠规范化设计。任务描述不指明目标文件、接口与操作边界,Agent 须从工作区中自行定位、对缺失约束作出合理假设并适时澄清——这使评测覆盖需求理解与定位能力,而非按图索骥的指令执行。欠规范化设计的边界由校验资产保障:存在多个合理答案的题目,必须同步编制多答案判定规则(如给出任意一个合理答案即判正确,见 2.5.3 节),确保开放性不损害可判定性。
第四步,校验资产编制。为每题编制 tests/ 目录下的三类校验资产:预期输出(业务正确结果,归属五种结果类型之一,并按精度偏差表设定容差,见 2.5.3 节)、确定性校验规则文件、Judge 评分规则(rubric 采用分级档位设计,见 4.3 节)。这一步的注意点是判定逻辑与题目同步定稿——怎么判对错在题目写成之时即已固定,而不是待评测结果产生后再补写;企业管理领域的全部预期输出还需经金蝶业务专家团队逐题人工确认(见 3.3 节)。
第五步,质检入库。入库前经七个维度的逐条检查——语义清晰度、意图完整性、无歧义性、业务合理性、难度标注准确性、表述自然度、唯一性——并按三档评级处置:通过即入库,一到两个维度不达标则退回限期整改,三个及以上维度不达标或业务不合理则退回重新设计(详见 3.3 节)。通过质检的题目打包为标准任务目录入库,随评测问题集封板统一冻结。
任务目录的字段级规范(任务元数据、评分配置与校验规则文件的格式)与一套完整任务目录样例,见附录 F。
3数据、环境与质量
3.1 数据来源与构建方式
两领域遵循统一的数据来源与构建方式。评测问题集数据均由公开资料合成,蓝本与题料来自金蝶公开资料:企业财报(三大报表、附注、分部报告等公开结构)、ESG 报告(业务流程与管理规定的公开描述)、金蝶社区帮助中心(费用管理、人人报销等产品知识),其公开性分类见表 8。在蓝本之上合成各领域评测所需的数据资产——通用领域为文档、表格、日程、图片等办公资产,企业管理领域为租户、客户、合同、单据、工单等业务资产——并遵循多题复用同一底层数据的原则,以降低评测集的存储与维护成本。内部数据源(模拟数据库、脱敏业务数据)仅用于出题过程的质量校验,不随评测集发布。
表 8 金蝶数据的公开性分类
| 数据 / 知识源 | 公开性类别 | 用途 |
|---|---|---|
| 金蝶社区帮助中心(费用管理、人人报销等产品知识) | 公开引用 | 通用领域题料(知识库检索) |
| 常见问题页与官网镜像 | 公开引用 | 通用领域题料(知识库检索) |
| 财报配套材料(投资者关系公开披露) | 公开引用 | 财务分析类题目的结构蓝本 |
| ESG 报告 | 公开引用 | 业务流程与管理规定类场景蓝本 |
| 业务数据库表(租户、客户、供应商、合同、单据、工单等) | 合成(mock) | 企业管理领域业务操作题数据资产 |
| 业务文件模板(合同、报表等文档模板) | 合成(mock) | 文档处理类题目资产 |
注:“公开引用”指直接使用可对外获取的金蝶公开资料;“合成(mock)”指在公开蓝本之上虚构构造的数据资产,与任何真实企业数据无对应关系,合成明细以发布版为准。
表 8 汇总本基准使用的金蝶数据及其公开性分类:一类是直接引用的金蝶公开资料(通用领域题料与场景蓝本),一类是在公开蓝本之上合成的模拟(mock)数据资产(企业管理领域业务操作题的数据基础)。两类数据的明细以发布版为准。
3.2 执行环境与可复现性
执行环境的核心约定是 Docker 镜像全内置:题目数据、工具与依赖全部打包进镜像,剥离外部 MCP 与 API 调用依赖。由此得到三个直接推论——离线可跑、第三方可复现、不设审批门槛。同时需要明确能力边界。本基准测量离线可控 ERP 沙箱中的任务能力:权限与审批控制在沙箱内以模拟方式覆盖——权限模型与人工审批点按任务配置并随治理层披露(见 5.1.2 节),越权操作列为致命项(见 4.3 节),异常状态类任务考察“已审核凭证不可直接修改”等控制约束(见 2.5.2 节);人机协同以统一模拟用户承接澄清交互(见 5.1.5 节)。被有意排除的是连接生产系统的在线要素——网络访问、实时数据与真实审批流转——这是为可复现性付出的外部效度代价;生产在线验证,以及更深入的职责分离、重复执行幂等与回滚补偿覆盖,列为扩展轨道(见第 8 章)。执行流程为:环境启动,Agent 运行,产物与日志收集,环境终态快照,后置校验。
终态评分:评分只认环境真实终态与产物日志,拒绝 Agent 自报成功;全程轨迹可事后审计[7]。数据独立性:不同题目不共享关键测试数据,每题预留独立的数据副本或恢复点,必须共享时明确执行顺序——保证评测运行的稳定性与结果可复现。超时与预算:任务级超时、步数与 token 预算、失败重试策略按任务配置并随评测设置披露。
澄清交互协议。欠规范化任务允许 Agent 向用户发起澄清,执行环境为此内置统一的模拟用户与答复脚本:应答范围——模拟用户仅就题目预置的可澄清项作答,答复脚本与校验资产同步编制,不提供超出题面的信息;等待与超时——澄清请求设有等待上限,超时后 Agent 须以明示假设继续执行或按未完成处理;假设规则——非关键缺省参数允许 Agent 自行假设但必须在产物中声明,关键业务参数(金额、科目、单据对象等)必须澄清后执行。统一协议确保不同 Agent 面对同样模糊请求时,选择澄清还是直接执行依据的是能力判断而非环境规则差异,评分对两种路径同等对待。答复脚本库与超时参数随《评测协议》公布。
答复脚本样例以样例题“一月销售月报”(2.5.4 节示例二)为例。该题预置的可澄清项为统计口径归属,题面声明“订单数据未提供业务员时,使用组织范围并说明该限制,不能把创建人、审核人或登录人猜作业务员”。相应问答为:Agent 问“订单数据中没有业务员字段,月报按什么范围统计?”,模拟用户按脚本答“按当前组织范围统计,并在月报中说明该限制”;Agent 若询问脚本未预置的问题,模拟用户仅以“以题面信息为准”一类统一话术回应,不提供超出题面的信息。两种执行路径评分同等对待:本题内容判据同步核对“按组织范围统计并说明该限制”的落实情况,澄清后执行与依题面规则直接执行面对同一判据。非关键缺省参数则无需澄清——如样例题“十二月经营分析报告”允许在元、万元等金额单位间自选、注明即可,Agent 可自行假设并在产物中声明。
反馈与测量分离:不在评测集内进行 Harness 或提示词调优;任何调优在分离的开发子集上进行,评测集保持 held-out 状态[8]。运行次数:每题执行多次独立运行,报告均值与 reliability@k(见 4.2 节)。
3.3 质量保证体系
题目入库前经过七个维度的逐条检查:语义清晰度(有且仅有一种合理解读)、意图完整性(主体、动作、对象、约束条件齐备)、无歧义性(无指代不明、多义词与边界模糊)、业务合理性(操作在真实系统中可行且符合业务规则)、难度标注准确性(实际复杂度与标注偏差不超过一个等级)、表述自然度(贴近真实用户语言)、唯一性(与已有题目语义重复率超过 80% 即去重)。评级三档:通过即入库;一到两个维度不达标则标注修改建议退回限期整改;三个及以上维度不达标或业务不合理则退回重新设计。
测试数据须满足三性:完备性——前置数据存在、关联数据完整、基础数据(科目、客户、供应商、物料等)就绪;有效性——业务对象状态与题目意图一致、时间相关数据处于正确期间、查询结果集规模合理;可验证性——预期结果可定义、可量化、可判定对错。
在通用质检之上,企业管理领域的全部校验预期输出经金蝶业务专家团队人工确认准确性。评测问题集经评审后封板(版本冻结),冻结版本内的题目不再修改;评测运行中发现的题目不合理项记入问题队列并全程留痕,修复统一纳入下一个版本发布、并在新版本上完整重跑——任一版本内的结果因此不受被测系统输出的影响,跨版本结果不做直接比较(见 4.2 节统计报告规范)。正式发布前,由灵基 Agent 先行完成一轮全量运行,并辅以多基线交叉试运行(不同能力档位的模型组合、规则系统与人工专家抽检):自评测保证“题目是否合理”在发布前即被感知,而非由外部使用者发现;多基线用于区分“题目缺陷”与“模型失败”——仅单一系统失败、而人工与多数基线均能通过的任务优先判定为题目缺陷并进入问题队列;题目难度标定同样采用多基线口径(见 4.4 节),避免题库质量与特定 Agent 的失败模式绑定。
4评测协议与指标
评测协议与指标服务于可复现、可比较的评测。本章立论于一个基本认识:评测得分是模型、Harness、环境与评测器四类因素的联合产物,并受协议(任务集、预算、重复运行次数、聚合规则)约束[2]。Lingee Bench 对每个被评组合分别固定其 Harness、环境与评测器,显式披露协议,使分数可归因于被评组合本身。
4.1 框架总体架构
图 2 给出评测流水线的总体架构。每道题目以自包含的任务目录提交;执行层在完全内置依赖的 Docker 环境中离线运行 Agent;Agent 运行结束后,评测层才被引入——解析脚本从产物日志与环境终态中提取事实,规则校验引擎与 LLM Judge 完成双通道评分,任务得分经宏平均聚合形成领域得分与报告。
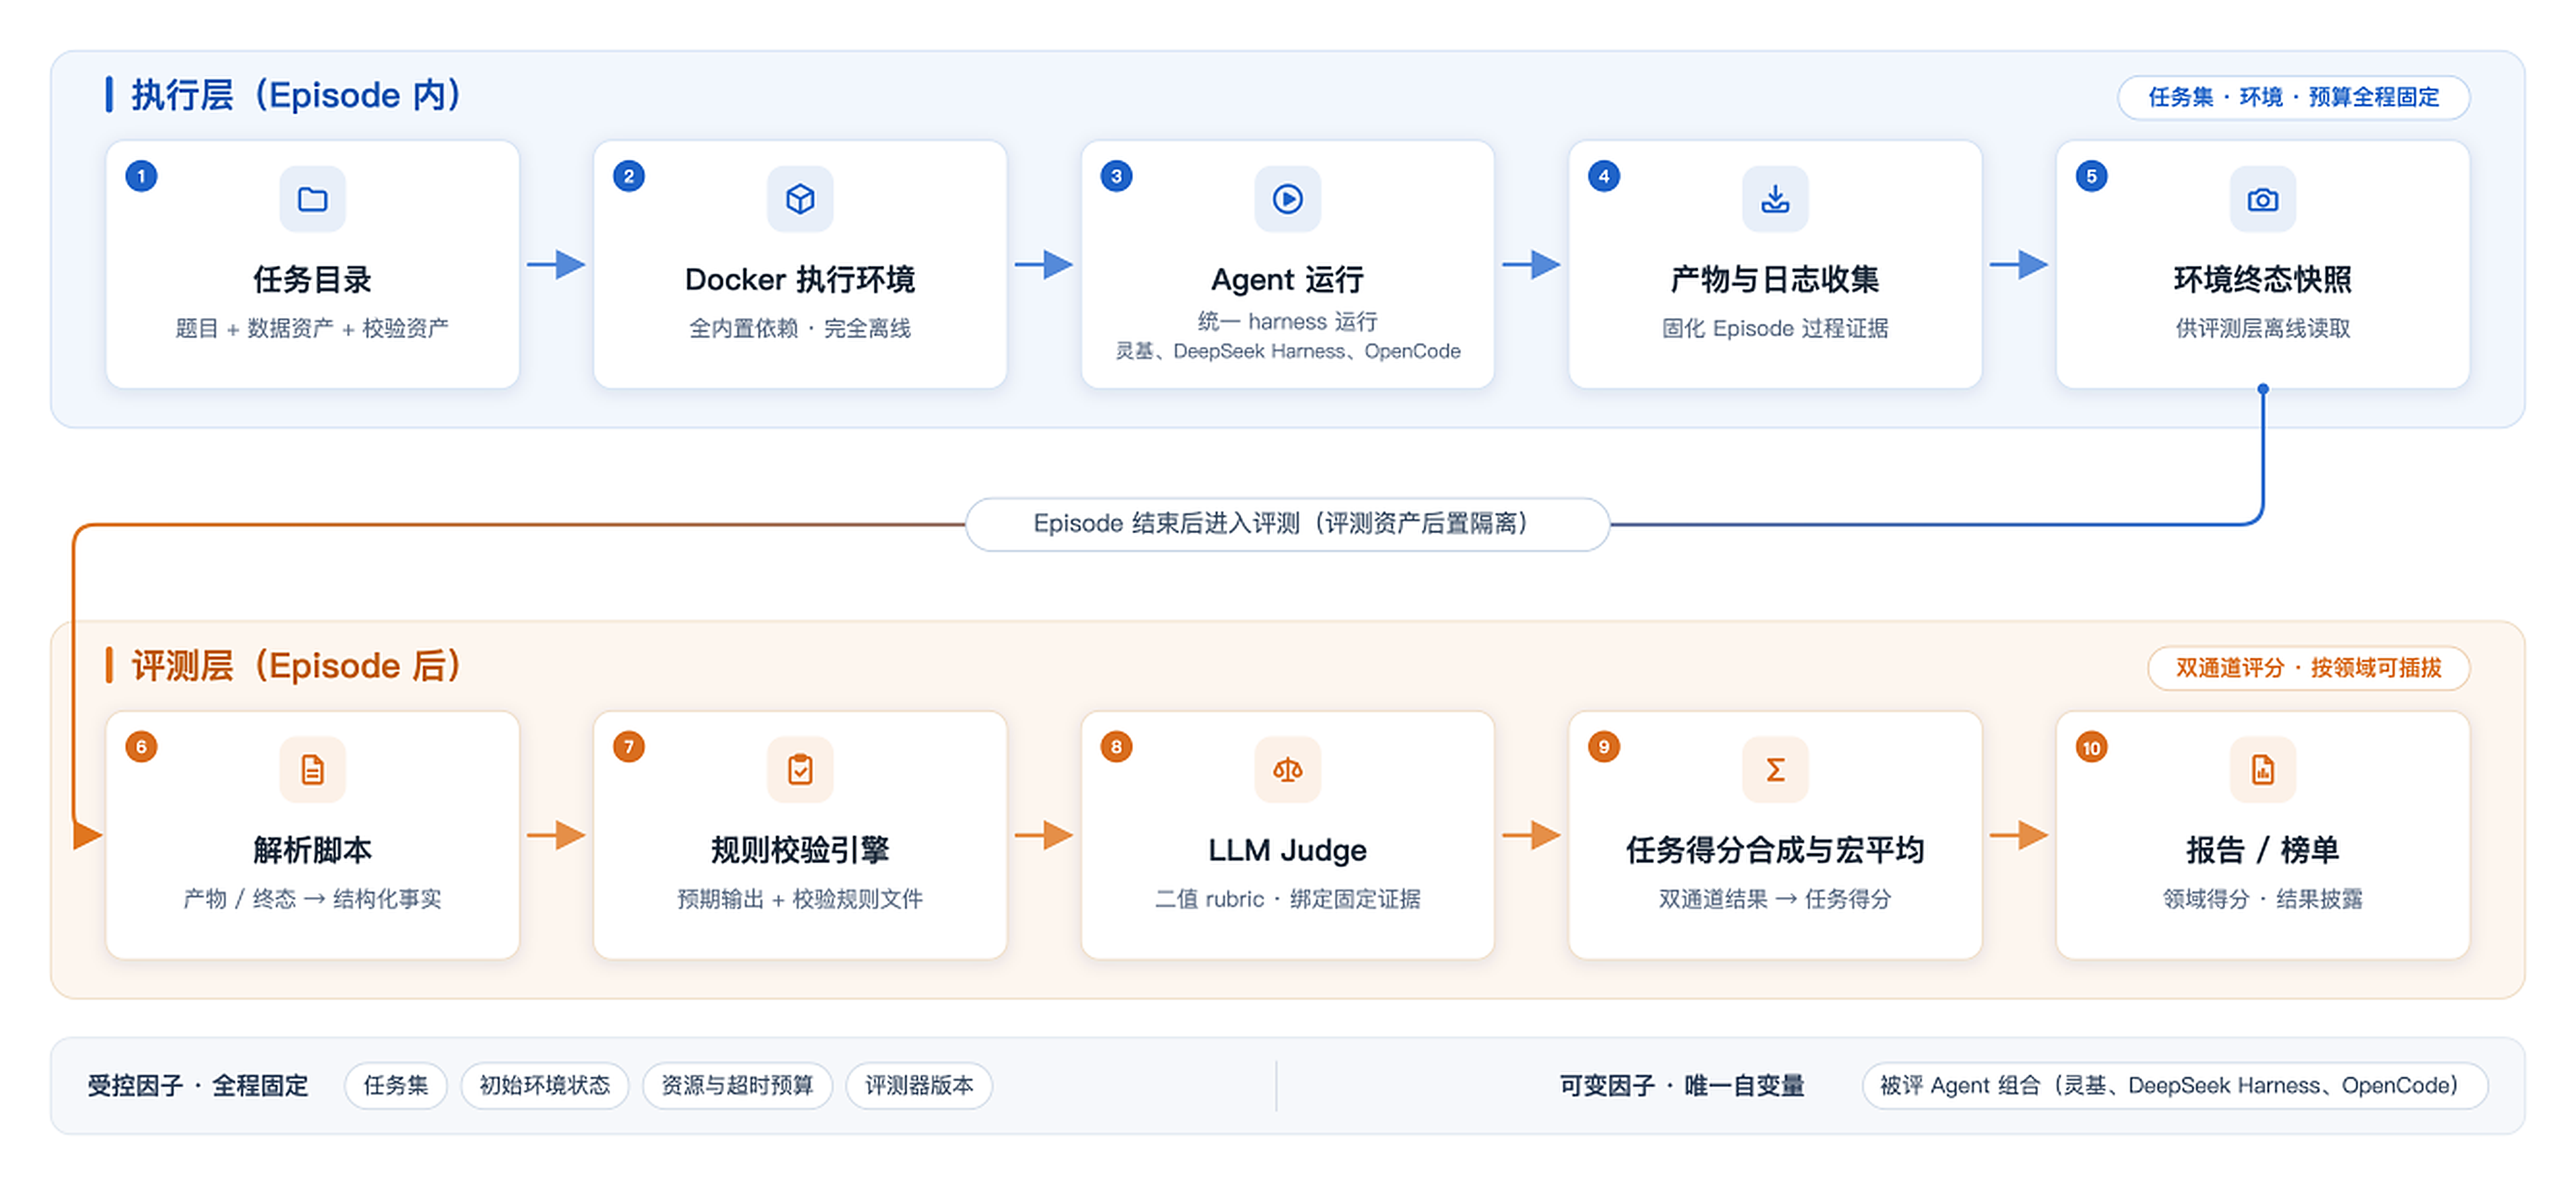
图 2 评测流水线总体架构(执行层与评测层以后置边界隔离)
框架有三个要点。其一,两大领域统一适用:通用领域与企业管理领域共享同一条评测管线,差异只体现在任务目录内的校验资产。其二,评分器按领域可插拔:规则校验与 Judge 的组合方式由每题的校验资产定义,管线本身不感知领域语义。其三,评测 Harness 不作为隐形的后台实现,而是被显式固定、随结果一同披露的评测组成部分[9]:执行层与评测层的每个环节(环境、预算、解析、校验、聚合)都有明确的版本与配置(见 5.1 节),使读者能分清分数中有多少来自模型能力、有多少来自脚手架。
受控因子与可变因子:任务集、初始环境状态、资源与超时预算、评测器版本在所有运行中保持固定;唯一的自变量是被评的 Agent 组合(首期为灵基、DeepSeek Harness、OpenCode 三个 Harness 的横向对比,见 5.1.1 节)。这一“受控因子表”的设计参照了 Harness 效应评测的规范做法[9]。
4.2 评测指标体系
Lingee Bench 从任务完成质量、Token 消耗与运行稳定性三个方面评价 Agent。任务完成质量为主指标,Token 消耗与运行稳定性独立报告,不合成为单一评分。通用领域与企业管理领域采用统一的指标定义,分别报告领域得分;企业管理领域进一步报告财务、供应链和制造三个维度的结果,不跨领域合成总分。
(1)任务完成质量。主指标为任务得分(Task Score),取值范围为 [0,1],衡量 Agent 在一次运行中满足任务要求的程度。本基准提供确定性规则校验与 LLM Judge 两类评分通道,根据任务验收要求配置评分方式。能够通过程序充分验证的任务采用确定性规则评分;涉及分析依据、解释完整性、建议合理性等语义质量要求的任务,在规则校验基础上引入 LLM Judge。评分方式及通道权重在评测前确定,具体计算方法见 4.3 节。
通用领域的判分对象是落盘产物而非执行过程:每题定义产物契约——文件清单与 result.json 等结构化摘要的必填字段,工具调用链属实现细节、不作为评分对象。规则校验覆盖四类对象:产物契约(文件、字段与表格结构,多轮任务按轮落盘);数值链——识别、计算与勾稽逐环核对,如票据金额识别、汇总总额须等于分项之和;格式规范,如发票号码须为规范格式并保留连字符;安全合规,如禁用词与联网链接零容忍。数值按等价口径核对,数值单元格与千分位字符串视为同一金额;核心数值错误(如任一票据金额错误)构成致命项,整次运行判零。
语义质量由 LLM Judge 以分级档位评分项评定,通用领域的典型评分项包括:整改建议是否针对主因科目并给出测算数字、知识库答案的来源标注是否真实存在且指向正确(引用接地)、有无编造知识库中不存在的功能或参数。评分通道与权重逐题声明、随题目封板冻结(示例见 2.4.3 各题卡片的得分构成)。
企业管理领域的规则校验覆盖业务结果及其约束。例如,财务任务检查金额、会计期间、借贷平衡和凭证状态;供应链任务检查订单与出入库单关联、数量一致性和库存变化;制造任务检查 BOM 关系、生产计划约束和工单状态。与之互补的是另一类语义质量要求,例如异常分析是否有证据支持、业务建议是否符合已知约束,以及报告是否完整说明未解决的问题。这类要求无法用确定性规则充分表达,由 Judge 评价。规则分与 Judge 分分别保留,用于区分客观结果错误与语义质量不足。
任务得分允许部分完成获得相应分数。每道任务预先声明核心交付门槛与致命项:核心交付结果缺失或不可解析,导致任务整体无法验收,或任一致命项失败时,该次任务得分为 0。其他交付缺失、内容错误或质量不足,按对应评分项计分。
对于设置了独立计分模块的任务,缺失或无法验收的模块计为 0,其他模块正常评分;仅在触发预先声明的任务级归零条件时,整题得分归零。模块划分、评分项及权重在评测前确定,缺失模块仍保留在评分范围内,不重新分配其权重。
每道任务执行多次独立运行,先对同一任务的有效运行得分取平均,再对领域内任务取等权宏平均,避免检查项较多或运行次数较多的任务获得更高权重。设参与汇总的领域任务集合为 T,任务 t 的有效运行集合为 A_t,单次运行得分为 S_{t,a},则:
S̄_t = (1/|A_t|) · Σ_{a∈A_t} S_{t,a}
TaskScore(T) = (1/|T|) · Σ_{t∈T} S̄_t
规则分与 Judge 分采用相同的两级聚合方式,其中 Judge 分仅在按设计启用该通道的任务范围内汇总,并披露覆盖范围。Agent 因推理或操作错误、耗尽执行预算或未完成任务而失败的运行,仍计入有效运行;评测技术异常按 4.3 节处理。正式结果应完成全部规定任务及有效运行次数;尚未完成时,须披露有效任务数、有效运行数与评测覆盖率,并标记为不完整评测。
(2)Token 消耗。Token 消耗用于描述 Agent 执行任务过程中的模型调用开销。企业管理场景中的财务核对、供应链分析、制造异常排查等任务,通常涉及多轮信息读取、业务判断与结果验证。上下文组织、任务分解及重试策略的差异,可能使 Agent 在取得相近完成质量时产生不同的 Token 消耗。因此,本基准将 Token 消耗作为资源使用指标,与任务完成质量联合报告。
本基准统计单次任务执行全过程的输入 Token、输出 Token 及总量,并按领域报告每任务平均消耗。统计覆盖执行过程中的全部模型调用,具体计数口径随评测配置披露;输入 Token 采用 cache-inclusive(含缓存读入)口径,不同模型使用不同 tokenizer,token 不是跨模型的恒定工作量单位,效率数字只在明确口径内解读,不作跨模型的严格效率排序。在相同模型、任务集与评测条件下,结合任务得分和成功率分析 Token 消耗,考察不同执行策略在完成质量与资源使用之间的权衡。在完成质量和成功率相近的情况下,更低的 Token 消耗反映出更高的资源使用效率。本基准同时记录每任务的端到端完成时长与交互轮次,与 Token 消耗一并作为效率指标报告:快速产出文字不等于快速交付业务结果,时长与轮次从交付时效与交互成本的角度补充刻画任务交付效率。
(3)运行稳定性。稳定性采用 k 次全通过率(reliability@k),衡量同一任务在 k 次独立运行中全部成功的比例;它与度量“至少一次成功”的 pass@k 含义相反,本文不使用后者[10]。任务得分衡量完成程度,二值成功判定(每次运行只记成功或失败)衡量完整完成能力:核心交付门槛与致命项通过、全部普通规则项通过,且按任务配置启用的全部 Judge 评分项通过时,该次运行记为成功,否则记为失败。仅规则评分任务依据核心交付门槛、致命项与规则项判定成功。缺少必需模块的运行可以获得部分任务分,但不记为完整成功。
设每题执行 n 次有效独立运行,其中任务 t 成功 c_t 次,对 k ≤ n,采用:
reliability@k = (1/|T|) · Σ_{t∈T} C(c_t, k) / C(n, k)
其中 c_t < k 时,该任务贡献为 0。reliability@1 即单次运行成功率,较大的 k 更强调持续、可靠地完成任务的能力。该指标在各任务完成规定次数的有效独立运行后计算。
重复运行须恢复相同的初始环境,固定任务、预算、工具与评分器配置,不继承前一次运行的产物或记忆,各次独立运行使用不同的随机种子。用于恢复评测技术异常的重试,不作为额外的独立运行计入稳定性统计。报告须披露重复次数、二项比例的置信区间及结果的不确定性,结合重复评测的波动判断分差是否稳定。辅助分析报告失败类型分布,区分交付缺失、数值或状态错误、业务约束违反、语义质量不足和执行预算耗尽等情况。
在宏平均之外,企业管理领域同时报告四类业务视角指标:风险加权分——按题目的业务风险等级加权,涉及资金收付、凭证过账、单据生效等高风险操作的任务权重上浮,权重在评测前随评分资产声明并冻结;关键流程端到端成功率——凭证录入→审核→过账→结账等完整业务链路任务的全链通过比例;致命错误率——触发致命项的运行占比,直接对应业务底线;功能边界正确率——对不支持或越权请求正确拒绝并引导的比例。宏平均回答整体完成水平,四类指标回答风险与底线是否守得住。
统计与基线设计。结果解读配备三类参照基线,均接入与被评对象相同的评测管线与评分资产,仅替换执行体。人工专家基线:业务专家在分层抽样任务上直接于评测环境中完成任务,报告完成率与耗时,作为能力上限参照。简单基线衡量不依赖 Agent 编排的完成水平,按题型模板构建、不逐题开发,含两种实现:其一,单轮直接调用基线——同一模型不经多轮循环、记忆与规划机制单次作答,用于分离模型基础能力与编排层增益;其二,规则脚本基线——面向可模式化的查询与单步操作类任务编写确定性脚本(题面解析→固定工具调用序列,不涉及大模型),衡量任务可被程序化解决的程度。随机基线:在合法动作空间内执行随机工具调用或产出随机内容,其期望得分构成得分下界参照,同时兼任评分器健全性检查——随机产物在某题上获得异常得分,即提示该题校验规则存在漏洞。
4.3 评分机制
Lingee Bench 采用以确定性规则校验为基础、按任务需要引入 LLM Judge 的后置评分框架。Agent 执行期间仅访问任务说明和允许使用的工作区;运行结束后,评测管线保存最终产物、环境终态与执行日志,再引入预期输出、校验规则及按任务配置启用的 Judge 评分资产。启用双通道评分时,两个通道分别生成并保留结果,Judge 不改写已记录的规则校验结论。评分设计参照智能体评测方法论的公开实践——以最终环境状态与产物为准、组合规则与模型裁判、以重复运行考察可靠性[11]。
任务评分衡量业务目标的达成程度与交付质量;Token 消耗作为独立的资源指标,随评分结果一并报告。
(1)确定性规则校验。每道任务预先定义业务预期结果、核心交付门槛和校验项。企业管理领域的预期结果由业务专家逐题确认;具有多个合理答案的任务,须明确可接受结果集合、数值范围或等价判定条件。精度、容差与多答案处理遵循 2.5.3 节的统一规范(表 6、表 7)。
解析脚本从最终产物、环境终态与执行日志中提取事实,再逐项验证。校验对象包括文件及字段结构、数值与公式、业务状态、跨文件或跨单据关系、副作用和执行边界。Agent 在最终回复中声明“操作成功”不能替代客观证据:凭证审核任务须检查实际凭证状态,出库任务须检查出库单及库存变化,生产任务须检查工单与相关业务记录。
核心交付门槛用于判断任务结果是否具备验收基础。文件生成任务检查核心产物是否存在于声明路径且可解析;系统操作任务检查目标业务状态是否能够读取并验证;查询与分析任务检查规定载体中是否提供可校验的答案。核心交付门槛仅覆盖任务成立所必需的结果。其他交付缺失或内容错误通过对应评分项评价,不统一作为整题归零条件。
校验项分为致命项与普通项。致命项用于表达不可接受的业务错误,例如借贷不平衡的凭证被保存为有效结果、越权修改业务数据,或产生任务明确禁止的副作用。任一致命项失败,该次运行得分直接归零。致命项单独记录,不参与普通规则分的分母。
确定性规则评分根据任务验收要求,采用整体通过判定或分项评分。采用整体通过判定的任务,仅在全部规定检查通过时取得规则分 1,否则为 0。采用分项评分的任务,通过普通规则项衡量部分完成程度,每项返回通过或失败。设任务 t 有 N_t 个普通规则项,结果为 c_{t,a,i} ∈ {0,1},则规则分为:
R_{t,a} = (1/N_t) · Σ_{i=1}^{N_t} c_{t,a,i}
分项评分的普通规则项等权计分,每道任务至少设置一个普通规则项。检查项应对应独立、可解释的要求,避免将同一要求拆成大量重复检查而改变其实际权重。
设置独立计分模块的任务须明确各模块对应的评分项。缺失或无法验收的模块,其对应规则项计为 0,并保留在评分分母中;其他模块继续按预置规则评分。
执行过程仅在任务明确要求操作顺序、授权或必要前置条件时纳入校验。例如,修改已审核凭证前须完成规定的状态处理。多条合法执行路径均应被接受,不要求 Agent 复现参考方案的完整工具调用序列。
(2)LLM Judge 评分。Judge 通道用于评价确定性规则难以充分表达的语义质量。是否启用该通道,由任务验收要求决定,并在评分配置中预先声明。每个评分项仅定义一个质量条件,按分级档位评定:逐项声明档位集合、各档判定标准与指定证据,档位最少为两档(通过/失败),语义质量需细分时采用多档(如 0~4 五级)。例如,“异常归因得到来源数据支持”“付款建议符合给定资金约束”“生产计划说明列出尚未解决的产能冲突”。评分条件须能够依据证据独立判定,避免使用“整体较好”等边界不明确的描述。
Judge 每次仅接收任务说明、规则校验结果及当前评分项指定的固定证据。证据由后置解析流程生成,可包括产物文本、表格数据与公式、渲染页面、业务状态摘要或必要的执行记录。Judge 不访问运行中的工作区,不自行补充外部事实,也不以产物中缺乏证据的自述作为业务正确性的依据。
设任务 t 有 K_t 个语义评分项,第 j 项按分级档位评定、所得档位记为 g_j、最高档位记为 G_j,档位折算值 b_{t,a,j} = g_j / G_j ∈ [0,1](通过/失败两档的评分项通过记 1、失败记 0),则 Judge 分为:
J_{t,a} = (1/K_t) · Σ_{j=1}^{K_t} b_{t,a,j}
每项判定须返回评分项标识、所得档位、证据引用及简要理由。产物本身缺少所需证据,或结论无法由指定证据支持时,该项计为最低档。对于独立计分模块,缺失或无法验收模块对应的 Judge 评分项计为 0,其他评分项正常评价,不因模块缺失而调整评分范围或分母。
评分项及参考证据在评测前经人工审核并冻结,所有被评配置使用同一版本,不依据某一 Agent 的输出调整标准。
(3)评分方式与合成。每道任务在评分配置中预先声明采用仅规则评分或双通道评分。仅规则评分任务在核心交付门槛与致命项通过后,直接以规则分作为任务得分。双通道评分任务根据客观结果与语义质量在任务验收中的相对重要性,分别设置规则分与 Judge 分的权重,两者之和为 1。
不同任务可采用不同权重,不设置统一的规则权重范围。评分方式、评分项与权重经审核后写入任务评分资产,并在评测前冻结。同一道任务对所有被评配置采用相同的评分规则,不随模型、执行策略或运行结果调整。
设 D_{t,a} 表示任务级核心交付门槛是否通过,F_{t,a} 表示全部致命项是否通过;无致命项时 F_{t,a} = 1。设双通道任务的规则权重为 w_t。对于能够形成有效评分结果的运行,单次任务得分为:
S_{t,a} = 0,                                 若 D_{t,a} = 0 或 F_{t,a} = 0
S_{t,a} = R_{t,a},                           若 D_{t,a} = F_{t,a} = 1(仅规则评分)
S_{t,a} = w_t·R_{t,a} + (1 − w_t)·J_{t,a},   若 D_{t,a} = F_{t,a} = 1(双通道评分)
评分通道的实际执行须与任务声明一致。双通道任务的加权合成以所需 Judge 结果有效为前提,不能因临时调用失败而改用仅规则评分。无论最终得分是否归零,均保留可获得的规则结果、Judge 结果和失败原因,以支持错误诊断与审计。任务与领域得分按 4.2 节规定的两级方式聚合。
(4)异常处理与质量验证。评测框架按照预置策略处理执行与评分过程中的技术异常,各被评配置采用一致的重试策略,并记录异常原因、重试次数与最终状态。评分阶段的重试基于同一次运行保存的产物与环境终态进行。
由评测基础设施引起的环境启动、通信、证据提取或评分服务异常,经重试仍无法形成有效评测结果的运行,标记为评测未完成,相应任务得分标记为不可用,并披露原因及评测覆盖情况。已获得的产物、日志与评分子结果予以保留,用于故障分析与审计。
Agent 在有效评测环境中因推理或操作错误、未完成任务或耗尽执行预算而失败的运行,依据停止时的产物与环境终态评分,并计入任务完成质量及运行稳定性统计。产物自身不可解析或缺少任务要求的证据,按照核心交付门槛及对应评分项处理。
启用 LLM Judge 的任务须开展评分质量验证,包括人工一致性、重复判定稳定性,以及适用评分项上的位置偏差、长度偏差和同源模型偏好检查。采用多 Judge 多数投票时,Judge 数量、模型版本、投票规则及分歧处理方式须在评测前固定。Judge 模型、提示词、证据提取程序和评分资产版本随结果一并披露;验证实验的抽样规模、一致率及偏差指标在完成实验后报告。
Judge 质量验证。为量化 Judge 通道的可信度,本基准设计了五项验证实验:(1)人工一致性——从两个领域分别抽样任务产物,由标注人员按同一评分细则独立逐档判定,报告 Judge 判定与人工判定的一致率,参照已有工作 90% 的一致性水平设定可接受阈值;(2)位置偏差——对成对比较类评分项交换呈现顺序后重新判定,检验结论翻转率;(3)长度偏差——构造语义质量相当、长度不同的输出对,检验 Judge 是否系统性偏向更长输出;(4)自我偏好——比较 Judge 模型与被评模型同源与异源两种设置下的一致率差异;(5)重复稳定性——同一证据在非零温度下重复判定多次,报告单次翻转率与多数投票的收敛性。
评分的可审计性由规范资产保证:权重与评分项配置表(各任务在评分资产中声明的通道选择与权重,评测前冻结)、致命项目录(致命校验的类目清单,如凭证借贷不平衡、越权与破坏性操作等,目录随版本维护与公示)、证据格式规范(Judge 评分项所绑定固定证据的字段与来源定义)、Judge 提示词模板与模型版本,以及人工仲裁机制——对 Judge 判定存在争议的案例由业务专家仲裁并用于校准 rubric;Judge 验证实验的任一偏差指标超出失效阈值时,该批 Judge 结果降级为参考并触发重新校准。上述资产合并为《评分规范》文档,发布范围见附录 C。
各资产的具体构成以六道样例题的评分资产为代表:权重与评分项配置表——每题声明评分模式(双通道或仅规则)与规则通道权重,六题权重在 0.3~0.7 之间,按判分对象的可判定性逐题确定、不设统一范围,评测前随题目封板冻结;规则通道的数值核验按业务专家确认的预期值执行公开结果表契约,只读取指定表名与列名的结果表、缺失值不按零计、同一业务键只列一行且多个产物间须一致。致命项目录——整题判零仅限评分资产中显式声明的致命判据(如关键金额识别错误),未声明的判据按自身等级进入对应通道计分。证据格式规范——Judge 评分项绑定的固定证据以“来源+定位+原文”三元组表达,证据清单、摘录及其与评分项的映射在评测前冻结,Judge 评定时不访问工作区。Judge 提示词模板——判据逐项独立评定,只按题面声明的等级档位判定、不重算数值真值,每项判定须引用给定证据的编号并说明理由,输出结构化结果且完整覆盖全部判据,无法完成合法判定记为评测故障而非候选零分。
Judge 评分项(rubric)按题型设计,统一以分级档位评定:文档与知识检索类绑定来源证据,评引用接地、要点覆盖与无编造;分析报告类评主题覆盖与分析实质(仅罗列构成不满足);交互交付类按可显示图表、卡片布局、抽屉导航等要素分档评定。评分项数量与粒度逐题声明,六道样例题的内容判据为 3~16 项。权重 w 为规则通道权重、逐题声明并随封板冻结,不设统一范围:数值与结构契约可精确核验的题目 w 较高(样例中最高 0.7),语义质量为主的题目 w 较低(样例中最低 0.3)。Judge 提示词口径与评分项全集随《评分规范》发布。
以企业管理领域的“两日工序质量对比”题为例(题面见 2.5.4 节示例三,深度分析见 5.2 节题六):该题采用双通道评分、规则权重 0.4,内容质量由 4 项判据评价,逐项按 0~4 五级分档评定,每项判据声明考察内容并绑定固定证据。表 9 节选其中两项判据的说明与分档定义。
表 9 制造质检题的 Judge 内容判据示例(节选)
| 评分项 | 判据说明(节选) | 分档定义(节选) |
|---|---|---|
| 两日指标对比 | 按题面约定的总体指标表展示两日首检通过率、巡检异常率与巡检计数等指标,变化方向与单位清楚,正式与补充口径区分明确;数值真值由规则通道独立核验,本项只评交付覆盖与表达,不重复扣数值错误。 | 0=没有任何可辨认的指标结果;1=只有个别日子的单一指标,没有两日对比;2=已有两日比较,但未使用约定总体指标表,或两项比率只呈现一项;3=两项两日比率已在约定表中,但巡检记录数或异常数、变化方向与单位、类型或口径区分仍有缺漏;4=约定表覆盖两项两日比率及两项巡检计数,变化方向和单位清楚,口径区分符合公开格式。 |
| 质量变化解读 | 解释首检、巡检与缺陷结构的变化,结合总体巡检记录数判断异常数量与异常率是否同向,说明计数与比例的区别;区分直接观察结果与待验证原因,不因个别指标改善即断言整体质量改善。 | 0=没有变化解读;1=只有质量变好或变差等笼统断言,没有数据关联;2=有部分趋势解释,但未覆盖首检、巡检、缺陷三方面,或未讨论异常数与异常率的方向及分母;3=三方面及异常数、异常率已有解释,但计数与比例、巡检记录数的关系不清,或把待验证原因写成已证实事实;4=三方面解读与所示结果对应,计数与比例的区别明确,直接现象与待验证原因区分清楚。 |
该题规则通道按公开结果表契约核验结果表数值,与上述内容判据按 0.4/0.6 权重合成任务得分,完整评分构成见 5.2 节题六。
评分模型与执行模型分离:LLM Judge 选用能力更强的模型担任评分模型,被评组合采用相对基础、更具性价比的模型担任执行模型,从源头降低评分与执行同源的自我偏好(相应验证见本节五项实验之四)。首期评测的评分模型为 GLM-5.3,执行模型为 GLM-5.3-Flash;完整版本号与推理参数随《评分规范》发布披露。
4.4 防污染的公开与保留双组设计
防污染首先来自构造方式:题目基于场景与公开资料重构合成,不复制任何公开题面,题面文本不可被网络搜索命中——可搜索题面路径在题目写成之时即被关闭。评测问题集数据全部由公开资料合成(见 3.1 节)。
在构造性防污染之上,本基准以分布相同的公开/保留双组设计把污染变为可持续测量的信号。评测集由公开发布与保留不发布两部分构成,两部分在场景类别、操作类型与难度分层上保持同分布。具体形态为:首批开源 65 题,任何人可下载并在本地 Docker 环境中离线复现;其余 1335 题保留,经Lingee Bench 官方网站提交评测。
同分布由可复核的三步构造过程保证。第一步,构建题目难度画像:基于发布前的多基线试运行数据——由不同能力档位的多个模型组合、规则基线与人工专家标定共同构成,不以单一被评对象的表现定义题目难度,运行次数 K 与基线清单随发布版披露——为每道题绘制 top-k 通过曲线——统计该题在 k 次独立运行(k = 1, 2, …, K)中的通过率及其变化,刻画题目的难度水平与得分稳定性;曲线特征与场景类别、操作类型、难度分层、业务模块等元数据共同构成该题的难度特征向量。第二步,匹配距离测算:在难度特征空间中,采用倾向得分匹配(Propensity Score Matching,PSM)框架下的最近邻匹配方法计算题目间的匹配距离,识别特征最接近的题目对——距离越近,两道题对同一被评组合的难度特征越接近。第三步,分层抽样:以场景类别、操作类型与难度分层为主分层维度,在各层内依据匹配距离完成两组的题目分配,使公开组的每道题在保留组中均有特征距离最近的对应题;两组由此不仅在各分层维度的占比上一致,在题目级难度画像的整体分布上也一致。
这一设计的工作原理是:分布相同的两组对同一模型的能力期望一致,若公开组的分数随模型与训练数据的迭代显著上升而保留组不动,两组差值(公开组−保留组)的扩大即为记忆效应的估计——它构成污染的早期预警信号,但不是污染的判定结论:解读差值前须先排除抽样误差(差值的置信区间)、题目版本变化(两组必须在同一版本快照上比较)与题目异质性等替代解释;保留组分数则始终代表模型在未见题目上的真实泛化能力,为评测结论提供不受基准定向优化影响的校准读数。
这一结构同时化解了评测集设计中的固有两难:全公开的评测集可复现但易被污染(SWE-bench Verified 因饱和与污染被 OpenAI 弃用即为例证),全保密的评测集防污染但第三方无法复现。本基准将两个目标解耦——公开组承载可复现性,任何人可离线复现;保留组承载可信度,任何时刻可用于校准。此外,分布相同的两组也是评测管线自身的对照平台:解析脚本、Judge 提示词等管线组件迭代时,先验证两组结论的一致性,防止评测器自身的漂移被误读为被测对象的变化。
需要说明的边界是:保留组同样存在泄露风险,轮换机制只能缓解、不能消除。泄露至少有三条现实通道。其一,分布外溢:两组分布相同是双组设计的前提,但也意味着公开的 65 题完整暴露了本基准的题面风格、场景构成、数据形态与难度画像——针对公开组做定向优化的模型,其收益会部分外溢到同分布的保留组上。其二,评测侧信道:保留组经官方网站受控评测,多次提交与得分反馈本身构成可探测的信号源,存在通过反复提交对隐藏题目做过拟合的空间——这一现象在带有隐藏测试集的公开榜单中已有先例。其三,构造同源:保留组题目与公开组一样基于公开资料与真实业务场景合成,题面虽经重构、不可被搜索命中,但其蓝本(财报结构、业务流程、产品知识)本就存在于训练语料中,模型对蓝本的熟悉会天然缩小两组差距;再叠加题目构造与评审需多人参与,题面片段经由对话记录、内部文档等渠道无意进入公开语料的可能性也无法归零。因此,本基准不声称绝对无污染,而是把污染当作需要持续管理的工程问题:双组设计使其可测量,分差监控使其可预警,版本轮换使其可治理;持续更新、版本轮换与提交治理的运营机制见第 7 章。
5评测运行与题目级深度分析
本章说明评测运行的设置与结果呈现方式。首期评测在公开组(首批开源 65 题)上对灵基、DeepSeek Harness、OpenCode 三个 Harness 完成受控横向对比(见附录 C),在本白皮书中从公开组抽取六道代表性题目作逐题深度分析,以具体案例展示评测体系的运作方式与结果的解读口径。本章结果的适用限定在 5.3 节统一声明,包括结果归属、比较口径、口径分离与外推边界;建议读者在引用本章任何数字前先行阅读该节。
5.1 评测设置
5.1.1 被评对象与评测制式
本基准的被评对象为“Harness 与模型的组合”(以下简称“被评组合”)。首期评测选取三个 Harness 做受控横向对比:灵基、DeepSeek Harness 与 OpenCode(opencode),在完全相同的题目、初始环境、预算与评分资产上运行,用于观察执行脚手架差异对任务完成的影响。需要首先明确的是,本基准定位为版本化、可复现的企业级评测套件,而非多模型横向对比榜单;三个组合的模型与版本配置逐项记录、随七层披露清单公布(见 5.1.2 节),结果解释为各被评组合在此评测资产上的表现,不构成对任一模型或任一 Harness 的独立评价。
评测采用 locked-harness(锁定脚手架)制式。该制式的选择并非覆盖面上的妥协,而是基于 Harness 效应研究对评测可信度提出的方法论要求。受控因子实验显示:在同一任务集下,更换执行脚手架(Harness)可使 Agent 得分移动 8.5~13 个百分点,而更换基础模型仅移动 2.5~5 个百分点;在 9 组对照实验中,6 组出现排名翻转,Harness 引起的分数方差可达到模型方差的 7.8 倍[5]。跨基准观测进一步表明,同一模型仅更换 Harness 的最大分差可达 53 个百分点[12][13]。这意味着,若评测不锁定并披露 Harness 配置,脚手架带来的性能收益极易被误归因为模型能力的进步,跨榜单、跨版本的分数比较也将失去可归因性。
因此,Lingee Bench 将 Harness 作为评测框架中显式固定、随结果全量披露的组成部分,而非隐形的后台实现。三个被评组合各自在受控且全量披露的 Harness 配置下运行,任务集、初始环境状态、资源与超时预算、评测器版本在所有组合的所有运行中保持固定;唯一的自变量是被评的 Agent 组合。这一“受控因子表”设计参照了 Harness 效应评测的规范做法[9],使同一组合内的比较具备一致性,使每个分数的归属组合(Agent × Harness × 环境 × 评测器)透明可查。
5.1.2 七层配置披露清单
评测设置按七层披露清单(HarnessCard)组织,每个被评 Harness 分别填报一份:灵基的填报见表 10,DeepSeek Harness 与 OpenCode 的 HarnessCard 待评测配置定稿后随发布版一并公布。该清单覆盖从执行环境到治理边界的完整配置链路,确保第三方能够理解、审计并在条件允许时复现评测运行条件。HarnessCard 连同预算配置、澄清交互中的人工帮助规则、环境快照版本与运行日期,构成每个被评组合的统一结果卡,随结果一并发布。
表 10 评测配置披露清单(七层)
| 层级 | 披露内容 | 首期配置要点(灵基 HarnessCard) |
|---|---|---|
| 执行(Execution) | 运行时、沙箱、文件与网络访问、任务超时、步超时、最大步数 | Docker 全内置离线沙箱;无外部网络访问;任务级超时与步数预算按任务配置并随结果披露 |
| 工具(Tool) | 工具清单、schema 风格、错误格式、可重试错误类 | 统一工具接口与 schema 风格;错误格式标准化;可重试错误类预先声明 |
| 上下文(Context) | 窗口上限、上下文排序与压缩策略、持久记忆 | 上下文窗口上限固定;排序与压缩策略版本化;持久记忆策略显式声明 |
| 调度(Scheduling) | Agent 循环、停止规则、重试、升级与回滚 | Agent 循环与停止规则锁定;重试与升级策略统一;回滚机制预置 |
| 可观测(Observability) | 轨迹格式、检查点、日志可审计性 | 全程轨迹记录;检查点机制;日志格式与审计接口标准化 |
| 验证(Verification) | 输出解析、校验、自检与异常检测 | 解析脚本版本化;校验规则与 Judge 配置冻结;异常检测机制预置 |
| 治理(Governance) | 权限模型、允许与禁止清单、副作用边界、人工审批点 | 权限模型锁定;允许/禁止清单明确;副作用边界声明;人工审批点按任务配置 |
七层披露的意义在于:它将评测配置从“不可见的实现细节”提升为“可审计的评测组成部分”。读者可据此判断分数中有多少来自模型能力、多少来自脚手架与配置选择;第三方可在相同配置下复现运行条件,或在明确配置差异的前提下进行受控比较。这一披露规范直接回应了 Harness 效应研究对评测可信度提出的新要求[5][2]。
5.1.3 配置记录与版本管理
在七层披露清单之外,推理与运行配置逐项记录并随结果发布,包括:模型与 Agent 版本、温度、top-p、最大输出 token、上下文窗口与压缩阈值、推理模式、每题独立运行次数,以及评测管线各组件的版本号。配置记录的目的在于使每一个分数都可回溯到确切的运行条件,避免“黑箱评测”带来的归因困难。灵基、DeepSeek Harness、OpenCode 三个被评组合的上述记录分别留存并随结果发布。配置记录与结果卡合一:任何一条对外发布的成绩,都可回溯到产生它的完整配置组合与运行日期。
版本管理遵循冻结与轮换原则:评测问题集经评审后封板(版本冻结),冻结版本内的题目不再修改;评测运行中发现的题目不合理项记入问题队列并全程留痕,修复统一纳入下一个版本发布,并在新版本上完整重跑。任一版本内的结果因此不受被测系统输出的影响,跨版本结果不做直接比较(见 4.2 节统计报告规范、3.3 节质量保证体系)。
5.1.4 评测环境与执行协议
评测环境与执行协议与 3.2 节一致:Docker 镜像全内置、离线执行、终态评分、数据独立性与预算控制;被评组合的预算与环境配置随统一结果卡披露(见 5.1.2 节),能力边界与外推限制见 3.2 节与 5.3 节的统一声明。
5.1.5 澄清交互协议
澄清交互协议与 3.2 节一致——模拟用户仅就题目预置的可澄清项作答、澄清请求设等待上限、非关键缺省参数可声明假设后执行、关键业务参数必须澄清,评分对澄清与直接执行两种路径同等对待;统一的模拟用户与答复脚本确保各被评组合面对同样的模糊请求,路径选择取决于能力判断而非环境规则差异。协议细则与答复脚本样例见 3.2 节。
5.1.6 反馈与测量分离
反馈与测量分离与 3.2 节一致:Harness 与提示词调优仅在分离的开发子集上进行,评测集保持 held-out 状态[8]。首期评测每题执行多次独立运行,报告均值与 reliability@k;重复运行的独立性要求与重试计入规则遵循 4.2 节的统计口径。
5.2 题目深度分析
六题的构成:通用领域 3 道,企业管理领域 3 道——财务、供应链、制造各 1 道。选题原则:通用领域三题覆盖不同能力大类与任务形态,均为规则+Judge 双通道评分,选定多发票批量识别入账(图片处理)、成本超支归因下钻(数据分析)与退款冲回连环追查(知识库检索),题目卡片见 2.4.3 节;企业领域三题分属不同业务模块,合计覆盖查询、操作、分析、文档处理中的多种操作类型,选定十二月经营分析报告(财务)、一月销售月报(供应链)与两日工序质量对比(制造),题目卡片见 2.5.4 节;六题整体覆盖至少两档难度。选题兼顾典型性与多样性,但不构成统计样本,案例结论不外推为整体表现。构成框架见表 11。
表 11 六题深度分析的构成框架
| 领域 | 数量 | 选题覆盖要求 |
|---|---|---|
| 通用领域 | 3 | 覆盖不同能力大类与任务形态;均为规则+Judge 双通道评分 |
| 企业管理领域 · 财务 | 1 | 覆盖财务业务模块的典型操作类型,难度与另两维互补 |
| 企业管理领域 · 供应链 | 1 | 覆盖供应链业务模块的典型操作类型,难度与另两维互补 |
| 企业管理领域 · 制造 | 1 | 覆盖制造业务模块的典型操作类型,难度与另两维互补 |
每题分析按统一模板展开,共六个部分:(1)任务卡片——业务目标与触发、初始上下文与数据资产、人的责任与可澄清项、系统终态与必备结果、评分构成;(2)各被评组合的表现概览与关键差异;(3)运行轨迹关键节点——定位、澄清、执行与交付的典型片段;(4)评分过程还原——规则项逐项判定结果、Judge 评分项与证据引用;(5)效率数据——token、轮次与端到端时长;(6)逐题解读——成功要素、失败模式及其业务含义。需要时引用基线对照(人工专家、单轮直接调用、随机基线)作为参照。
示例一 多发票批量识别入账(图片处理·L2·单轮,任务卡片见 2.4.3 节示例一)
表现概览:灵基任务得分 1.0——23 个规则组全过、Judge 五项评分项全过。DeepSeek Harness 的三种工具调用模式在本题明显分化:标准函数调用模式同样拿到满分;Code Mode(以生成代码批量编排工具调用)会话未开展有效工作即结束,整题零分;双开模式(同时开放两种调用方式)任务得分 0.87,三张发票的号码全部识别错误,仅金额与汇总正确。
轨迹与评分:双开模式的失分全部落在发票号码的来源引用校验上——小字号票号中高混淆字符(O 与 0、I 与 1)的识别精度是 OCR 硬能力的直接体现。灵基三张全对,在超时临界点前完成识别、加总与表格落盘,产物规范性同时经 Judge 认证。
效率与解读:本题说明重任务的会话稳定性是先决条件——Code Mode 单次生成体量大、出错面大,一次会话失效即整题归零;在识别层面,金额普遍能读对,票号这类高混淆字符串才是真正的分水岭。
示例二 成本超支归因下钻(数据分析·L3·多轮,任务卡片见 2.4.3 节示例二)
表现概览:灵基任务得分 1.0——三轮计算(各部门超支率、最大超支部门、科目下钻金额、整改测算)六个规则组全过,Judge 三项评分项全过。DeepSeek Harness 标准模式 0.883,业务内容五组全过、唯一失分为输出安全禁词组,其 Code Mode 与双开模式亦拿到 1.0;OpenCode 在本题的失分同样落在安全合规规则组。
轨迹与评分:跨轮衔接是主考点——第 2、3 轮的分析对象不出现在题面中、由前轮结论动态决定,灵基三轮数字层层勾稽、无中途漂移。对照组的计算本身正确,失分源于整改建议中的免责声明模板反向命中题面禁词(“投资建议”“税务筹划”类表述)。
效率与解读:本题是“内容双对、合规分胜负”的典型——输出措辞是否业务化(给出重新议价、调整采购批量等具体动作)而非模板化兜底,直接决定规则组得失;终轮产物组装与跨轮一致性是多轮任务的另一条隐含考点。
示例三 退款冲回连环追查(知识库检索·L4·单轮,任务卡片见 2.4.3 节示例三)
表现概览:灵基任务得分 1.0——23 个规则组全过、Judge 六项评分项全过,是知识库检索类的双通道满分样例。判定焦点在引用接地与无编造两项评分项:关键结论的来源标注须真实存在且指向正确,Judge 依据的证据清单与摘录在评测前冻结、Judge 不访问工作区。
轨迹与评分:七个问题环环相扣,后一问的检索线索(概念名、单据名、参数名)须从前几问读到的文章中获取——灵基以已检索内容中的术语发起下一轮检索,在相近主题文章并存的干扰下无错配,引用严格限定在证据清单之内,并覆盖了题面未提示、需从知识库原文自行提炼的隐含要点。
效率与解读:证据纪律决定知识库问答的可信度——为把答案说圆而补充一条看似合理的来源即构成幻觉引用、整条判负;“宁可少引、绝不外延”比答得全更能保证答案可验证。
示例四 十二月经营分析报告(财务·单轮,任务卡片见 2.5.4 节示例一)
表现概览:灵基任务得分 1.0——四组数值核验(营业收入,资产总计、负债合计与资产负债率,货币资金,经营活动净现金流)全部给出且与确认值一致,16 项内容判据对应的分析主题全覆盖,Markdown 与 HTML 双格式报告通过人工校验。OpenCode Judge 分 1.0、规则分 0、任务得分 0.70;DeepSeek Harness Judge 分 0.84、任务得分 0.59。
轨迹与评分:取数深度是首要差异——灵基 55 次工具调用覆盖多期利润表(含全年逐月)、各三期的资产负债表与现金流量表、科目余额及维度数据,据此识别出收入趋势异常、预收款与收入的结构性背离等单期截面得不到的结论;两个对照组各 16~21 次调用、只取十二月单期截面,无任何趋势分析。规则分的零分并非算错——对照组正文中的多数数值实际正确,失分全部来自结果表契约:营业收入未在结果表报告、金额单位标注与现金流列定位不合规。
效率与解读:灵基的 HTML 报告内置机器自检(图表数量、抽屉导航、数据溯源、无残留)并逐项通过,这是对照组未做的步骤。本题显示多期多源取数与产物自检是分析报告类任务的得分基础,而“正文正确”与“结果表合规”是两类独立能力。
示例五 一月销售月报(供应链·单轮,任务卡片见 2.5.4 节示例二)
表现概览:灵基任务得分 1.0——签单金额、订单笔数、准时交货率与退货率四项数值核验全部给出且与确认值一致,客户与物料贡献、交付异常、回款风险与下月建议齐备,月报通过人工校验。OpenCode Judge 分 1.0、规则分 0、任务得分 0.60,两项比率标注“未提供”;DeepSeek Harness 在 1200 秒预算内超时、未产出任何产物,任务得分 0。
轨迹与评分:取数方式具有决定性——灵基以服务端过滤一次取全(单据状态、审核日期窗口与销售组织组合过滤),五次调用分别取得本月、环比、同比与两个状态口径的数据;OpenCode 对同一数据做了 13 次分页加偏移二分探测才确认总量,DeepSeek Harness 派出三个子代理逐页转储、每页消耗一次模型调用。指标口径知识是第二道分水岭:对照组对指标接口只会分页盲翻,见值为零即判定“系统集成指标、不可用”,两项比率写“未提供”,规则分按“无适用引用”计零。
效率与解读:数据获取成本从“页数×模型调用”压缩到常数次调用,是本题最显著的效率差异,也直接决定了 DeepSeek Harness 的超时。灵基对两处接口超时的指标明确标注“未知、非零”,缺失数据不填零的契约纪律同时得到校验。
示例六 两日工序质量对比(制造·单轮,任务卡片见 2.5.4 节示例三)
表现概览:灵基任务得分 1.0——五项总体指标全部与确认值一致,另附高风险工序清单、两份可视化报告与三条业务建议。OpenCode Judge 分 1.0、规则分 0.83、任务得分 0.93,缺陷总数计数错误;DeepSeek Harness 任务得分 1.0。
轨迹与评分:本题的隐藏考点是分页完整性——灵基每日一次调用、页大小一次取全两日全部记录,并在首次返回空结果后自行纠正日期参数的时间戳精度;OpenCode 将首页两条有效记录当作空值丢弃,缺陷明细少三条导致计数错误;DeepSeek Harness 发现单据行数缺口后按单号与工序编码做了四轮交叉复核补齐。计算方式亦有差异:灵基把指标计算交给脚本执行后转述结果,OpenCode 全程由模型直接推算,末次模型调用输出达 3.1 MB。
效率与解读:一页取全从源头规避分页丢行,优于事后自检补救;确定性计算与产物自检结合,是数值密集型任务兼顾得分与效率的稳定路径。三个组合在本题分差小于前两题,说明当任务口径完全公开、以计数为主时,能力差距会收窄。
综合六题的逐题分析,关键发现有两条。
关键发现其一:企业业务场景的第一分水岭是领域取数方式,而非计算能力。三道企业题中,灵基凭借接口选择、服务端过滤参数与指标口径知识,以常数次调用取全所需数据;两个对照组分别依赖分页盲翻、偏移二分探测或子代理逐页转储,最重的销售月报题在预算时间内未产出任何产物。“知道查什么、用什么参数查”决定任务能否完成,其后才轮到“算得对不对”。
关键发现其二:内容正确与交付合规是两类独立能力,双通道评分将两者分开度量。企业侧,对照组正文中的多数数值实际正确,却因结果表契约不合规(指标未入表、单位与列定位不符)在规则通道失分;通用侧,对照组的计算与检索内容正确,因输出中的免责声明模板系统性触发安全禁词而丢分,灵基全程零触发。对业务方的含义是:“结果可核对”与“产物可信赖”须分别验收,任一短板都会在任务得分中显性呈现。
5.3 结果使用边界与比较口径
本基准定位为版本化的评测套件,而非通用排名榜单。首期评测在公开组 65 题上完成了灵基、DeepSeek Harness、OpenCode 三个 Harness 的受控横向对比,遵循同一比较口径,即受控配置比较:固定任务、工具契约、初始环境、预算与评分资产,仅切换被评的 Agent 组合,用于观察模型、上下文组织、工具使用或执行框架各自的贡献。它不等同于客户采用完整产品后的体验,也不构成对其他模型或其他 Harness 的评价;Harness 效应研究已证明跨 Harness 的分数差异可达数十分[5][12][13],缺少适配条件的系统在本基准中标记为“未覆盖”并说明原因,不按能力零分处理。两领域评分器构成不同,不跨领域加总、不报告总平均;六题案例不构成统计样本,不用于推断整体表现或进行排名。
统计与外推边界:落在重复评测噪声带内的小分差,不构成组合间真实差异的证据[14][13];案例中观察到的差异以轨迹与证据解读,不以单题成败外推整体优劣。离线沙箱的边界同样适用:结果不外推到包含网络访问、实时数据与真实审批流转的在线场景,也不直接换算为业务覆盖率、岗位替代率或成本节省(见 3.2 节、第 6 章)。待多系统同协议结果积累后,本基准再行扩展跨系统对标;届时完整产品形态的比较(各产品以正式可用能力接入、统一业务目标、初始状态与总预算)与人工及既有流程的对照,将作为独立的比较协议另行发布(见第 8 章)。
6业务价值与采用验证
本章说明本基准结果与业务价值之间的连接方式。需要首先声明:截至本版发布,本基准的评测均在离线沙箱中完成,尚无客户试点与商业采用数据;本章给出的是验证方案与度量口径,而非任何已验证的价值结论。有限题库上的离线成功率,不能直接换算为真实业务覆盖率、岗位替代率或年度节省。
6.1 三层证据框架
本基准把“Agent 有业务价值”的论证拆为三层证据,逐层验证、分别披露。能力证据:离线沙箱中的任务与流程表现(见 5.2 节);业务证据:客户试点中按事先约定的业务验收标准取得的成果确认与实际改善;经营证据:持续运行、合同收入与交付经济性。三层证据的连接关系是:能力证据是必要条件而非充分条件——沙箱通过说明具备承担业务的基础,客户试点验证真实约束下的表现,经营证据确认商业上成立。
6.2 客户试点验证方案
客户试点以共同验收为核心设计。任务来源:从客户真实业务中选取代表性任务,与题库任务家族对齐,在客户数据与权限环境内执行。验收标准:客户业务专家与交付团队事先约定业务终态与必要控制,验收人、观察窗口与排除条件在试点开始前书面固定。对照设计:可采用同期对照、分阶段推广或匹配流程比较,先记录既有流程的基线表现(耗时、质量门槛、返工),再引入 Agent 方案度量变化;试点至少覆盖正常业务周期与典型异常事件,不以模拟环境或测试租户的结果代替真实业务验收。
6.3 采用与价值的度量口径
试点与采用阶段度量四类指标:首次合格率——首次提交即通过业务验收的比例;人工投入——审阅、澄清、审批与救援投入的有效工作时间,其中协议必需的人工审批与额外人工救援分开记录,不把合规协同误算为能力失败;单位验收成功成本——全部试验成本(含失败、重试、审阅、接管与返工)除以验收成功数,成功数为零时标记为不可计算;交付时效——端到端完成时长与人工有效工作时间的对比。价值评估采用净增量价值口径:可确认的增量收益与实际成本改善,减去 AI 方案的全部增量成本(软件、推理、集成、治理与维护)。释放的工时先记为容量改善,仅在出现加班、外包或人员成本等实际变化时才计为现金节省;现金占用释放与利润改善分别计算,避免重复计量。
6.4 采用验证的边界与声明
三点声明。其一,本章不构成任何商业价值承诺,引用本基准结果时不得以离线分数直接推断业务或经营结论。其二,客户试点涉及客户数据与生产环境,其结果经客户同意后以案例形式披露,试点数据不进入题库。其三,离线分数与客户现场表现的相关性本身是被验证的对象——若相关性弱,应修订任务分布与评分设计,而非继续增加题目(见第 8 章)。
7治理、版本与生态
一个基准的可信度,一半来自方法设计,另一半来自长期治理。本章说明Lingee Bench 的组织职责、版本机制与生态规则;相关细则随评测规范文档四份(评测协议、隐藏集治理规则、评分规范、统计报告规范)一并公布(见附录 C)。
7.1 组织与职责分离
本基准由金蝶发起并建设,评测管线与首期结果均由金蝶自建自评,厂商身份与利益关系特此声明。为控制自评偏差,建设过程实行职责分离:出题(业务专家独立命题)、评测执行(评测工程)、评分资产维护(评分规范与 Judge 校准)、隐藏集治理(提交治理与轮换决策)分属不同角色;业务专家参与定义预期输出与争议仲裁,但不参与对自家产品的结果解释。方法、评分资产与开源题目全量公开、支持第三方独立复现与审计——公开可复核是对厂商身份最直接的制衡(见 4.3 节 Judge 质量验证与 3.3 节多基线交叉试运行)。
7.2 版本与更新治理
版本语义:任务、数据、环境、协议与裁判资产分别编号,重大口径变化开新版本;评测问题集经评审后封板(版本冻结),冻结版本内题目不再修改,评测中发现的题目不合理项记入问题队列,修复纳入下一版本并在新版本上完整重跑,跨版本结果不做直接比较(见 3.3 节)。
持续更新与版本轮换:版本迭代时,将部分保留组题目轮换为公开,同时补充新的保留组题目——公开评测集因此常新,校准组因此常在;开源规模随版本逐步扩大,公开组对整体分布的代表性随之持续增强。
官方网站受控评测遵循明确的提交治理规则,防止保留组退化为可反复试探的开发集:提交配额与冷却期——同一账号对同一题目版本的提交次数受限,两次提交之间设冷却期;反馈粒度受限——评测服务仅返回总体与分领域层面的聚合得分,不返回逐题对错等题目级反馈;账号与审计——提交账号实名登记,提交与查询全程留痕;异常检测与轮换——对短时间异常提升、疑似逐题探测的提交模式进行检测,触及阈值的保留题目进入轮换队列;结果保密——未经提交方同意不公开其结果,对外展示遵循发布策略。
更新节奏与退役:勘误与定向回归按月处理,可比较结果按季度或重大变化发布;高分饱和的任务保留作回归用例,污染、失真或过时的任务进入退役清单并公示;新增难题时不静默改变历史分数,受影响的历史成绩按版本语义回算或标注。
7.3 生态贡献与申诉
本基准接受行业伙伴与研究者的贡献,贡献类型包括任务与场景、行业数据与环境定义、校验器与 Judge 校准案例。贡献遵循统一规则:任务须通过七维质检与业务合理性评审(见 3.3 节),数据须满足来源公开与脱敏要求(见 3.1 节),校验器须通过随机基线健全性检查(见 4.2 节);被采纳的贡献以版本化方式进入题库,贡献者获得署名与结果引用说明。对评测结果存在争议时,可通过申诉通道提交复核请求,由业务专家与评测团队联合仲裁,仲裁结论与评分资产修订随版本记录公示。生态治理的目标是让基准从厂商自建走向多方共建:以清晰的贡献规则、独立的复现通道与透明的申诉处理,逐步建立行业公信力。
8局限性与路线图
本基准存在五点局限。其一,题目规模与业务覆盖度有限:1400 题覆盖财务、供应链、制造三个维度,HR、营销、法务等管理域尚未纳入。其二,场景特定性:题目根植于金蝶 ERP 生态与中文企业场景,结论向其他企业软件生态或语言外推需谨慎。其三,校验表达边界:确定性规则难以覆盖完全开放的任务,LLM Judge 虽扩展了可评范围,但引入了模型裁判的固有偏差,本框架以证据绑定与双通道分离缓解而非消除。其四,快照曝光风险:发布后的评测集存在被训练语料吸收的风险,版本化管理缓解但不消除。其五,组合覆盖有限:首期评测仅覆盖灵基、DeepSeek Harness、OpenCode 三个被评组合,不构成对其他模型或 Harness 的评价。
未来工作按三个阶段展开。近期(随首版发布):深化沙箱内控制类覆盖——审批与职责分离、重复执行幂等、撤销回滚与补偿场景进一步纳入异常处理维度与致命项设计;完成全量结果审核并确定评测结果的发布渠道与形式;基于失败模式分析驱动产品与评测资产迭代。中期:扩展组织协同层——以跨岗位、跨时间的业务事件为评测单位,检验共同目标、责任交接、授权升级与人工接管;建设在线与权限评测轨道(受控网络访问、实时数据与审批流转的受控版本);在保持披露规范的前提下扩展多系统同协议的矩阵评测并公开对比。长期:按行业标签扩展行业任务包并与行业伙伴共建(见第 7 章),探索题目辅助生成与自动质检以提高题目生产效率,以及把 Harness 作为可进化变量的评测探索[13]。各阶段不设固定时间表,以证据积累与治理资源就绪为准。
9附录
附录 A 术语表
表 A-1 术语表
| 术语 | 定义 |
|---|---|
| Lingee Bench / lg-bench | 本评测基准的名称与代号;由通用领域与企业管理领域构成 |
| 灵基 | 灵基是金蝶研发的企业级Agent操作系统 |
| 通用领域 / 企业管理领域 | 两大题目领域:前者衡量通用办公与工程基础能力,后者衡量 ERP 业务场景的端到端任务能力 |
| 任务目录 | 自包含的题目打包单位:任务定义、执行环境(含打包工作区)与判分资产(tests/) |
| Episode | 一次任务运行的完整过程,从环境启动到 Agent 停止 |
| 评测资产后置 | 校验资产仅在 Episode 结束后引入的执行期隔离机制 |
| 预期输出 | 题目的业务正确结果,与校验规则文件共同构成确定性校验基础 |
| 校验规则文件 | 题目级确定性校验规则的定义文件,含致命项与普通项 |
| 规则分 / Judge 分 | 确定性校验通过率 / LLM Judge 分级档位评分项的档位折算平均 |
| 任务得分(Task Score) | 主指标:规则分与 Judge 分按任务权重合成的任务级得分∈[0,1] |
| 宏平均(macro-average) | 对任务集内各任务得分取简单平均的聚合方式 |
| 致命项 | 校验失败即令任务得分为 0 的规则(如借贷不平衡、越权操作) |
| reliability@k | 同一任务 k 次独立运行全部成功的比例,稳定性指标 |
| 轮次(turns) | 一次运行中 Agent 消息轮数的计数值 |
| locked-harness | 锁定统一执行脚手架并全量披露配置的评测制式 |
| 欠规范化 | 任务描述有意省略目标文件、接口与边界的构造设计 |
| 任务家族 | 同一业务目标下不可互相替代的独立业务场景;同一家族内的模板变体只计一个独立场景 |
| 三层评测架构 | 基础能力(通用领域,工作包级)—业务流程(企业管理领域,任务链级)—组织协同(跨岗位事件处置,扩展方向)的评测层级 |
| 结果卡 | 随成绩发布的统一配置披露单元:HarnessCard 七层配置,加预算、人工帮助规则、环境快照版本与运行日期 |
附录 B 数据来源说明
评测问题集数据均由公开资料合成。公开蓝本包括:金蝶社区帮助中心(费用管理、人人报销等产品知识,https://vip.kingdee.com)、金蝶投资者关系公开财报材料、公开 ESG 报告。在此之上合成的业务数据资产(租户、客户、合同、单据、工单等)均为虚构构造,与任何真实企业数据无对应关系。
附录 C 发布内容清单
本附录逐项声明Lingee Bench 的内容边界:哪些内容对外发布、哪些不发布,以及哪些数据从未被使用。本清单只描述内容边界,不涉及发布渠道与时间安排。
表 C-1 发布内容清单
| 内容 | 状态 | 说明 |
|---|---|---|
| 白皮书(本文) | 发布 | 评测框架、指标体系、评分机制与六题深度案例分析 |
| 评测题目与任务目录(公开组,首批 65 题) | 发布 | 任务描述与工作区数据资产,开源可下载、离线复现 |
| 保留题目组(1335 题) | 不发布 | 不直接开源,经Lingee Bench 官方网站提交评测;与公开组分布相同,用于污染监控与版本轮换 |
| 评测规范文档四份(评测协议、隐藏集治理规则、评分规范、统计报告规范) | 待定 | 配套白皮书方法论的可执行规范:接入接口与澄清交互、提交治理与反作弊、权重与致命项目录及 Judge 仲裁、分层指标与置信区间及版本可比规则;发布范围随发布版确定 |
| 评测环境定义 | 发布 | Docker 环境构建定义,支持离线复现 |
| 统一结果卡模板 | 发布 | 每个被评组合的配置与运行条件模板,随评测结果发布 |
| 校验规则 | 发布 | 确定性校验规则与 Judge 评分规则对外公开,支撑评测复现与评分审计 |
| 预期输出 | 不发布 | 题目的业务正确结果保密,防止答案泄露与针对评测的定向优化 |
| 首期评测统计结果(灵基、DeepSeek Harness、OpenCode × 公开组 65 题) | 审核中 | 评测运行已完成,结果正在审核中,审核通过前不披露;白皮书不收录统计性结果,仅以六题深度案例呈现,发布渠道与形式随发布版确定 |
| 六题深度案例分析 | 发布 | 通用领域 3 题+财务、供应链、制造各 1 题的逐题分析,见第 5 章 |
| 全量评测运行结果(1400 题) | 审核中 | 评测运行已完成,结果正在审核中,审核通过前不披露 |
| 原始轨迹等完整评测细节 | 不发布 | — |
| 用户数据与真实企业数据 | 从未使用 | 评测问题集数据由公开资料合成,与真实企业数据无对应 |
| 内部题池演进信息 | 不发布 | 对外以发布版为第一版 |
注:“从未使用”指在题目构造与评测全过程中均未使用。
附录 D 行业评测榜单调研清单
本附录为第 1.2 节论证所依据的行业评测榜单调研的完整清单。调研对象共 37 项,按通用 Agent(12 项)、Web/GUI(8 项)、代码工程(8 项)、企业办公(5 项)与聚合型(4 项)五类组织,其中 15 项为模型与云厂商主导或联合发布的基准(腾讯、字节跳动、阿里巴巴、华为、MiniMax、微软、Google、AWS、苹果、OpenAI、Meta 与智谱),分属通用 Agent、代码工程与 Web/GUI 三类;调研维度覆盖评测场景、数据开源性、评分方式(是否采用 LLM Judge)、可复现性与持续更新状态等。表 D-1 摘录其中与本文论证最相关的信息,供读者按图索骥。
表 D-1 37 项行业评测榜单调研清单
| 序号 | 榜单名称 | 类别 | 主办组织 | 评测场景 | 数据开源 | LLM Judge | 持续更新 |
|---|---|---|---|---|---|---|---|
| 1 | AgentBench | 通用 Agent | 清华大学THUDM (唐杰/黄民烈团队) | 通用Agent 8环境: OS/DB/KG/卡牌游戏/谜题/家务/网购/浏览 | 是 | 否 | 是 |
| 2 | GAIA | 通用 Agent | Meta AI/FAIR + Hugging Face (Yann LeCun, Thomas Wolf等) | 通用AI助手 (多模态: 文本/音频/文档/图片) | 部分 | 否 | 是 |
| 3 | τ-bench (tau-bench) | 通用 Agent | Sierra (Bret Taylor创办, 估值45亿美元) | 工具-智能体-用户交互 (航空/零售/电信/银行) | 是 | 否 | 是 |
| 4 | xbench | 通用 Agent | 红杉中国/Hongshan Group (HSG, 原Sequoia China) | AGI能力前沿+产业实用 (ScienceQA/DeepSearch/招聘/营销) | 是 | 是 | 是 |
| 5 | BrowseComp | 通用 Agent | OpenAI | 浏览智能体 (web browsing, hard to solve) | 是 | 是 | 否 |
| 6 | DeepResearch Bench | 通用 Agent | 研究团队 (Ayanami0730, 100+领域专家参与) | 深度研究智能体 (PhD级别跨领域任务) | 是 | 是 | 是 |
| 7 | WebArena | Web/GUI | CMU NeuLab (Graham Neubig) | Web自动化 (电商/论坛/GitLab/地图/维基百科) | 是 | 否 | 是 |
| 8 | VisualWebArena | Web/GUI | CMU (同WebArena团队) | 多模态视觉Web任务 (需理解页面截图) | 是 | 否 | 否 |
| 9 | OSWorld | Web/GUI | 香港大学XLang Lab (联合Salesforce/CMU/Waterloo) | 真实操作系统桌面GUI (Ubuntu/Windows虚拟机) | 是 | 否 | 是 |
| 10 | Mind2Web | Web/GUI | OSU NLP Group (俄亥俄州立大学) | Web代理通用性 (离线HTML快照, 跨任务/网站/域泛化) | 是 | 是 | 是 |
| 11 | WebShop | Web/GUI | Princeton NLP Group (Karthik Narasimhan) | 电商购物 (模拟电商网站, 118万真实商品) | 是 | 否 | 否 |
| 12 | AndroidWorld | Web/GUI | Google Research/DeepMind (Alphabet) | Android移动端GUI (116任务, 20个真实应用) | 是 | 否 | 是 |
| 13 | SWE-bench | 代码工程 | Princeton (Carlos Jimenez, Alexander Wettig等) | 真实GitHub issue解决 (软件工程, 12个Python仓库) | 是 | 否 | 是 |
| 14 | SWE-bench Verified | 代码工程 | Princeton + OpenAI合作 | SWE-bench人工验证子集 (500题) | 是 | 否 | 否 |
| 15 | LiveCodeBench | 代码工程 | UC Berkeley / MIT / Cornell | 实时代码生成 (LeetCode/Codeforces/AtCoder) | 是 | 否 | 是 |
| 16 | Terminal-Bench | 代码工程 | Stanford × Laude Institute (harbor-framework) | 终端命令行任务 (hard, realistic) | 是 | 否 | 是 |
| 17 | OfficeBench | 企业办公 | UC San Diego / UCLA / Allen Institute for AI (AI2) | 多应用办公自动化 (Docker模拟9个应用: Word/Excel/PDF/Calendar/Email/OCR/ChatGPT/Shell) | 是 | 否 | 否 |
| 18 | WorkArena | 企业办公 | ServiceNow Research (NYSE: NOW, 2025年营收132.9亿美元) | 企业知识工作 (ServiceNow平台6大类: 知识库/表单/服务目录/列表/图表/仪表盘) | 受限 | 否 | 是 |
| 19 | Salesforce CRM Benchmark | 企业办公 | Salesforce AI Research (NYSE: CRM, 2026财年415.25亿美元) | CRM (Sales/Service/Field Service三大领域) | 否 | 否 | 是 |
| 20 | DrBench | 企业办公 | ServiceNow Research | 企业级深度研究 (10领域: Sales/网络安全/合规等, 3行业: 零售/医疗/电动汽车) | 是 | 是 | 是 |
| 21 | AgentLab | 企业办公 | ServiceNow Research | 评测框架 (聚合12+个benchmark: WorkArena/WebArena/OSWorld/MiniWoB等) | N/A | 否 | 是 |
| 22 | LMArena (Chatbot Arena) | 聚合型 | LMSYS Org (UC Berkeley/UCSD/CMU 学术非营利) | 通用LLM/Agent对话 (众包人类投票Elo评分) | 是 | 否 | 是 |
| 23 | Artificial Analysis | 聚合型 | Artificial Analysis (商业公司) | LLM/Agent聚合对比 (有Agentic Index和Coding Agents专门子榜) | 否 | N/A | 是 |
| 24 | LLM-Stats | 聚合型 | YC S25创业公司 | LLM/Agent聚合对比 (300+模型) | 部分 | N/A | 是 |
| 25 | OpenLegion | 聚合型 | OpenLegion (Agent运行时公司) | benchmark解读文章 (非独立leaderboard, 整合SWE-bench/GAIA/WebArena等) | N/A | N/A | — |
| 26 | Tencent WorkBuddy Bench | 通用 Agent | 腾讯 Tencent (38位作者团队) | 多域coding agent (Code/Web/Office/Security四域) | 是 | 部分 | 是 |
| 27 | Multi-SWE-bench | 代码工程 | 字节跳动 ByteDance Seed | 多语言代码agent (Java/TS/JS/Go/Rust/C/C++ 7种语言) | 是 | 否 | 是 |
| 28 | Web-Bench (ByteDance) | 代码工程 | 字节跳动 ByteDance | Web开发agent (前端开发, 顺序依赖任务) | 是 | 否 | 是 |
| 29 | EdgeBench | 通用 Agent | 字节跳动 ByteDance Seed | 长周期自主学习agent (科学/ML/系统工程/优化/知识/游戏, 最长12小时) | 是 | 否 | 是 |
| 30 | DeepPlanning (Qwen) | 通用 Agent | 阿里巴巴 Qwen团队 | agent规划 (旅行规划中英各120题 + 购物规划120题) | 是 | 否 | 是 |
| 31 | OmniBench (华为) | 通用 Agent | 华为云启创新团队 + 北大/人大/北理工/清华 | 全场景agent (ToC消费22域 + ToB企业38域 + ToE员工30域), 十维能力含办公任务 | 是 | 未明确 | 是 |
| 32 | OctoCodingBench (MiniMax) | 代码工程 | MiniMax | 代码agent过程合规 (7种指令来源遵循: 系统提示/用户查询/AGENTS.md/技能调用等) | 是 | 未明确 | 是 |
| 33 | Windows Agent Arena (WAA) | Web/GUI | Microsoft Research | Windows桌面OS级任务 (文档/表格编辑/浏览/系统操作/编码/工具) | 是 | 否 | 是 |
| 34 | aws-bench (AWS) | 代码工程 | Amazon/AWS | AWS云运维agent (Introspection诊断 + Mutation创建/修改AWS资源) | 是 | 部分 | 是 |
| 35 | MMAU (Apple) | 通用 Agent | Apple 基础模型团队 (Ruoming Pang, Zirui Wang等) | 多任务agent理解 (工具调用/DAG QA/数据科学编程/竞赛编程/数学, 5领域×5能力) | 是 | 否 | 是 |
| 36 | ToolSandbox (Apple) | 通用 Agent | Apple | 有状态多轮对话式工具调用 (工具间隐式状态依赖) | 是 | 未明确 | 是 |
| 37 | VisualAgentBench (VAB) | Web/GUI | 智谱 AI (清华大学 THUDM 团队) | 视觉agent (具身/GUI/视觉设计, 5个环境: OmniGibson/Minecraft/Mobile/WebArena-Lite/CSS) | 是 | 否 | 是 |
注:调研信息基于各基准论文、官方文档与公开榜单页整理,截至本白皮书撰写时;“数据开源”“LLM Judge”“持续更新”三列为概括性归类,开源许可、防污染机制、更新机制等明细以各基准官方资料为准。
附录 E 相关工作与代表性基准对比
E.1 文献与基准版图
Agent 评测研究可归为六条线索。其一,Harness 评测线(2026 年最新进展):Harness-Bench 度量配置级 Harness 效应并确立“受控因子”实验范式[9];Stop Comparing 提出评测配置七层披露清单与方差分解协议[5];The Harness Effect 揭示编排层对企业 Agent token 成本的决定作用[15];Rethinking Harness Evolution 确立“优化反馈与最终测量分离”的评测原则[8];HarnessOpt-Bench 提出噪声带与 headroom 归一化增益[14];GABench 与 HarnessDev 分别给出跨 Harness 分差的实证[12][13]。其二,高引综述:KDD'25 的 Agent 评测全景综述[1]、五视角评测综述[16]与 harness-aware 四因素框架综述[2]。其三,经典 Agent 基准:GAIA[17]、SWE-bench[18]、OSWorld、WebArena、AgentBoard 等。其四,企业域基准:τ-bench 及 τ²-bench[10]、CRMArena[19]、WorkArena[20]、WorkBuddy Bench[6]、ITBench。其五,裁判方法论:MT-Bench 与 Chatbot Arena、Agent-as-a-Judge[7]、LLM-as-a-Judge 综述[21]。其六,立场与标准化:AI Agents That Matter 主张准确率与成本、可复现性联合报告[22];CUBE 探索统一 Agent 基准标准。
E.2 与代表性基准的对比
表 E-1 从场景、防污染、评分方式、业务级校验、可复现性与配置披露六个维度,对比七项代表性基准与本基准。
表 E-1 代表性 Agent 基准对比
| 基准 | 场景 | 防污染 | 评分方式 | 企业业务 | 可复现/披露 |
|---|---|---|---|---|---|
| GAIA | 通用助手 | test 答案保密 | 精确匹配 | 无 | 可复现/无披露框架 |
| SWE-bench | 代码工程 | gold patch 公开,存在污染 | 隐藏测试 | 无 | 可复现/无披露框架 |
| τ-bench | 客服对话 | 数据开源 | 确定性状态验证 | 对话域 | 可复现/pass^k |
| OSWorld | 真实 OS | 数据开源 | 混合判定 | 无 | 可复现/无披露框架 |
| WorkArena | 企业 SaaS | 数据开源 | 确定性校验 | ServiceNow | 需审批访问 |
| CRMArena | 企业 CRM | 数据合成 | 确定性为主+人工 | Salesforce CRM | 可复现 |
| WorkBuddy Bench[6] | 多域 coding-agent | 题面不可搜索 | 规则+Judge 双通道 | 办公场景 | 开放发布/双 Harness |
| Lingee Bench | 通用办公+ERP 业务 | 构造性合成+版本化 | 规则+Judge 双通道+业务专家确认 | 财务/供应链/制造 | Docker 全内置离线/locked-harness 七层披露 |
注:对比基于公开资料与 37 项榜单调研整理(完整清单见附录 D);各基准特性以其论文与官方文档为准。
E.3 差异化定位
在上述版图中,Lingee Bench 的差异化定位有四点。场景差异:唯一将 ERP 核心业务(财务、供应链、制造)作为核心评测场景的企业级基准,补齐了企业办公类基准“模拟环境或封闭系统”的缺口。校验差异:确定性规则与 LLM Judge 双通道之上,引入业务专家人工确认预期输出的机制,使“业务级正确”有了可问责的判定来源。框架差异:locked-harness 制式配合七层配置全量披露、Docker 全内置离线复现与题目持续更新,直接回应了 Harness 效应研究与评测可复现性讨论对评测可信度提出的新要求。防污染机制差异:分布相同的公开/保留双组使污染可测量、可监控、可治理,优于单纯依赖构造性改写或答案保密的静态做法。
附录 F 任务目录规范与完整样例
任务目录是Lingee Bench 的基本发布单元:每道题目对应一个自包含目录,携带任务定义、执行环境与全部判分资产,可独立构建、独立运行、独立复现(任务元数据见 2.6 节,执行环境见 3.2 节)。本附录给出任务目录的字段级规范,并以公开组题目“退款冲回连环追查”为完整样例;该题的题目卡片见 2.4.3 节示例三。
F.1 任务目录字段级规范
一个任务目录由三部分构成:任务定义(instruction.md 与 task.toml)、执行环境(environment/)与判分资产(tests/,即 2.6 节所述三类校验资产的落地形态)。各文件的职责与关键字段见表 F-1。
表 F-1 任务目录的文件构成与职责
| 文件/目录 | 所属部分 | 职责与关键字段 |
|---|---|---|
| instruction.md | 任务定义 | Agent 可见的唯一题面:业务场景、输入资产、任务口径、产物契约与安全约束 |
| task.toml | 任务定义 | 任务元数据:任务标识与名称、能力类目与子类、难度分层与任务标签、执行预算(Agent 与判分超时)、环境资源声明(CPU、内存、存储、构建超时) |
| environment/Dockerfile | 执行环境 | 镜像定义:基础镜像与预装运行时(样例题为 Python 3.12 与 Node.js 20) |
| environment/docker-compose.yaml | 执行环境 | 容器编排定义 |
| environment/workspace.tar.gz | 执行环境 | 工作区初始资产,解压后即为 input/ 输入文件 |
| tests/verifier.toml、tests/test.sh | 判分资产 | 判分运行器配置与入口:判分命令、超时与工作目录 |
| tests/judge.yaml | 判分资产 | 评分配置:产物清单、Judge 评分项(编号、评分问题、指定证据、各档判定标准)与双通道权重 |
| tests/gold/gold_answer.json | 判分资产 | 标准答案与规则组定义(预期输出) |
| tests/gold/judge_evidence.json | 判分资产 | Judge 固定证据:依据文章清单、知识库原文摘录、评分项与证据映射,评测前冻结 |
| tests/gold/ 三类准入样本 | 判分资产 | 判分配置的准入校验样本:标准答案须评得满分,基线答案须评得零分,关键词全中而语义全错的对抗答案须得部分分 |
| tests/grading/ | 判分资产 | 判分实现:规则评分、Judge 调用与产物提取脚本 |
来源与授权信息随任务元数据一并记录,口径与附录 B 的数据公开性分类一致;本附录给出的是发布版任务目录的构成规范,个别字段值以发布版为准。
F.2 任务目录完整样例
样例选取“退款冲回连环追查”(知识库检索,L4)。公开组 65 题中,该题的判分资产层次最为齐全——知识库输入、23 个规则组、六项 Judge 评分、冻结证据与三类准入样本齐备,能完整走一遍目录规范的每个部分。其目录结构如下:
KBR-refund-reversal-chain-tracing-L4/
├─ instruction.md                    任务说明:题面与产物契约
├─ task.toml                         任务元数据与环境声明
├─ environment/
│   ├─ Dockerfile                    镜像定义(预装运行时)
│   ├─ docker-compose.yaml           容器编排
│   └─ workspace.tar.gz              工作区资产 → input/kb/(69 篇知识库镜像)
└─ tests/
    ├─ verifier.toml / test.sh       判分运行器配置与入口
    ├─ judge.yaml                    评分配置(6 项 Judge 评分项、双通道权重)
    ├─ grading/                      判分实现(run_grade / score_core / judge_core)
    └─ gold/                         gold_answer.json、judge_evidence.json 与 oracle / baseline / adversarial 三类准入样本
表 F-2 样例任务的元数据与环境声明(task.toml 摘录)
| 声明字段 | 样例值 |
|---|---|
| 任务标识 | KBR-refund-reversal-chain-tracing-L4(发布名:退款冲回连环追查) |
| 能力类目/子类 | 知识库检索/多源连环检索问答(链式 RAG) |
| 难度与标签 | L4;任务标签覆盖领域、能力类目与难度分层 |
| 执行预算 | Agent 超时 1800 秒,判分超时 1800 秒 |
| 环境资源 | 2 CPU、4096 MB 内存、10240 MB 存储、无 GPU,构建超时 300 秒 |
| 预装运行时 | Python 3.12 与 Node.js 20(由 Dockerfile 固定) |
| 输入资产 | input/kb/:69 篇 Markdown 知识库镜像,文件名为文章 ID,文首为文章标题 |
样例的 judge.yaml 声明唯一主产物 output/answer.txt,定义六项分级档位评分项(通过/失败两档)——两步处理顺序、隐藏字段取值规则、退款方式与金额限制的归属、差旅案例收口、引用接地、无编造——每项绑定指定证据,双通道权重为规则 0.5、Judge 0.5。gold_answer.json 逐问给出标准答案,由 23 个规则组分项核对;judge_evidence.json 冻结六篇依据文章的清单与九条知识库原文摘录,并给出评分项与证据的映射,对应 4.3 节的证据格式规范。三类准入样本随目录归档:标准答案须评得满分,基线答案须评得零分,关键词全中而语义全错的对抗答案须落在两者之间——判分配置通过准入校验后方可随题目封板。
该样例体现了任务目录的设计意图:题面、环境与全部判定资产随目录一并分发,任何人都可在本地构建同一环境、执行同一题目并运行同一判分,得到可比对的结果——这是公开组离线复现(见 4.4 节)与发布内容可复核(见附录 C)的落地形态。
10参考文献
[1] Mohammadi M, Li Y, Lo J, et al. Evaluation and benchmarking of LLM agents: a survey[C]//Proceedings of the 31st ACM SIGKDD Conference on Knowledge Discovery and Data Mining. New York: ACM, 2025.
[2] Radwan A Y, Vasilakos A V, Raza S. Harness-aware evaluation of LLM agents: systems, benchmarks, and protocols[PP/OL]. Preprints.org (2026-09-24)[2026-10-20]. https://www.preprints.org/manuscript/202609.2140.
[3] Patwardhan T, Dias R, Proehl E, et al. GDPval: evaluating AI model performance on real-world economically valuable tasks[PP/OL]. arXiv (2025-10-05)[2026-10-20]. https://arxiv.org/abs/2510.04374.
[4] OpenAI. Why we no longer evaluate SWE-bench Verified[EB/OL]. (2026-02-23)[2026-10-20]. https://openai.com/index/why-we-no-longer-evaluate-swe-bench-verified/.
[5] Zhang Y, Wang J, Ge Y, et al. Stop comparing LLM agents without disclosing the harness[PP/OL]. arXiv (2026-05-07)[2026-10-20]. https://arxiv.org/abs/2605.23950.
[6] Cai S, Chen S, Fei X, et al. Tencent WorkBuddy Bench: a multi-domain coding-agent benchmark with contamination-resistant task construction[PP/OL]. arXiv (2026-07-23)[2026-10-20]. https://arxiv.org/abs/2607.20911.
[7] Zhuge M, Zhao C, Ashley D R, et al. Agent-as-a-Judge: evaluate agents with agents[PP/OL]. arXiv (2024-10-16)[2026-10-20]. https://arxiv.org/abs/2410.10934.
[8] Wang Y, Zhu H, Hu Z, et al. Rethinking the evaluation of harness evolution for agents[PP/OL]. arXiv (2026-10-05)[2026-10-20]. https://arxiv.org/abs/2607.12227.
[9] Yao Y, Tan X, Liu C H, et al. Harness-Bench: measuring harness effects across models in realistic agent workflows[PP/OL]. arXiv (2026-05-27)[2026-10-20]. https://arxiv.org/abs/2605.27922.
[10] Yao S, Shinn N, Razavi P, et al. τ-bench: a benchmark for tool-agent-user interaction in real-world domains[PP/OL]. arXiv (2024-06-17)[2026-10-20]. https://arxiv.org/abs/2406.12045.
[11] Anthropic. Demystifying evals for AI agents[EB/OL]. (2026-01-09)[2026-10-20]. https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents.
[12] Tan J, Zhang Z, Guo Y B, et al. GABench: a comprehensive benchmark for evaluating LLM agents on graph analysis tasks[PP/OL]. arXiv (2026-08-03)[2026-10-20]. https://arxiv.org/abs/2608.01684.
[13] Wu Y, Zhang J, Shi J, et al. HarnessDev: can LLMs create and evolve their own agent harness?[PP/OL]. arXiv (2026-09-01)[2026-10-20]. https://arxiv.org/abs/2609.01437.
[14] Ursekar V, Shanker A, Maurya Y, et al. HarnessOpt-Bench: evaluating LLMs at harness optimization[PP/OL]. arXiv (2026-08-06)[2026-10-20]. https://arxiv.org/abs/2608.06301.
[15] Sayed Ali M, Novik A, Boddupally A, et al. The harness effect: how orchestration design sets the token economics of enterprise agentic AI[PP/OL]. arXiv (2026-10-05)[2026-10-20]. https://arxiv.org/abs/2607.06906.
[16] Yehudai A, Eden L, Li A, et al. A survey on evaluation of LLM-based agents[PP/OL]. arXiv (2026-04-23)[2026-10-20]. https://arxiv.org/abs/2503.16416.
[17] Mialon G, Fourrier C, Swift C, et al. GAIA: a benchmark for general AI assistants[PP/OL]. arXiv (2023-11-21)[2026-10-20]. https://arxiv.org/abs/2311.12983.
[18] Jimenez C E, Yang J, Wettig A, et al. SWE-bench: can language models resolve real-world GitHub issues?[C]//Proceedings of the 12th International Conference on Learning Representations. 2024.
[19] Huang K H, Prabhakar A, Dhawan S, et al. CRMArena: understanding the capacity of LLM agents to perform professional CRM tasks in realistic environments[PP/OL]. arXiv (2025-02-16)[2026-10-20]. https://arxiv.org/abs/2411.02305.
[20] Drouin A, Gasse M, Caccia M, et al. WorkArena: how capable are web agents at solving common knowledge work tasks?[PP/OL]. arXiv (2024-07-23)[2026-10-20]. https://arxiv.org/abs/2403.07718.
[21] Gu J, Jiang X, Shi Z, et al. A survey on LLM-as-a-Judge[PP/OL]. arXiv (2025-10-19)[2026-10-20]. https://arxiv.org/abs/2411.15594.
[22] Kapoor S, Stroebl B, Siegel Z S, et al. AI agents that matter[PP/OL]. arXiv (2024-07-01)[2026-10-20]. https://arxiv.org/abs/2407.01502.